Kimi K3: il modello open da 2,8 trilioni di parametri di Moonshot AI, spiegato
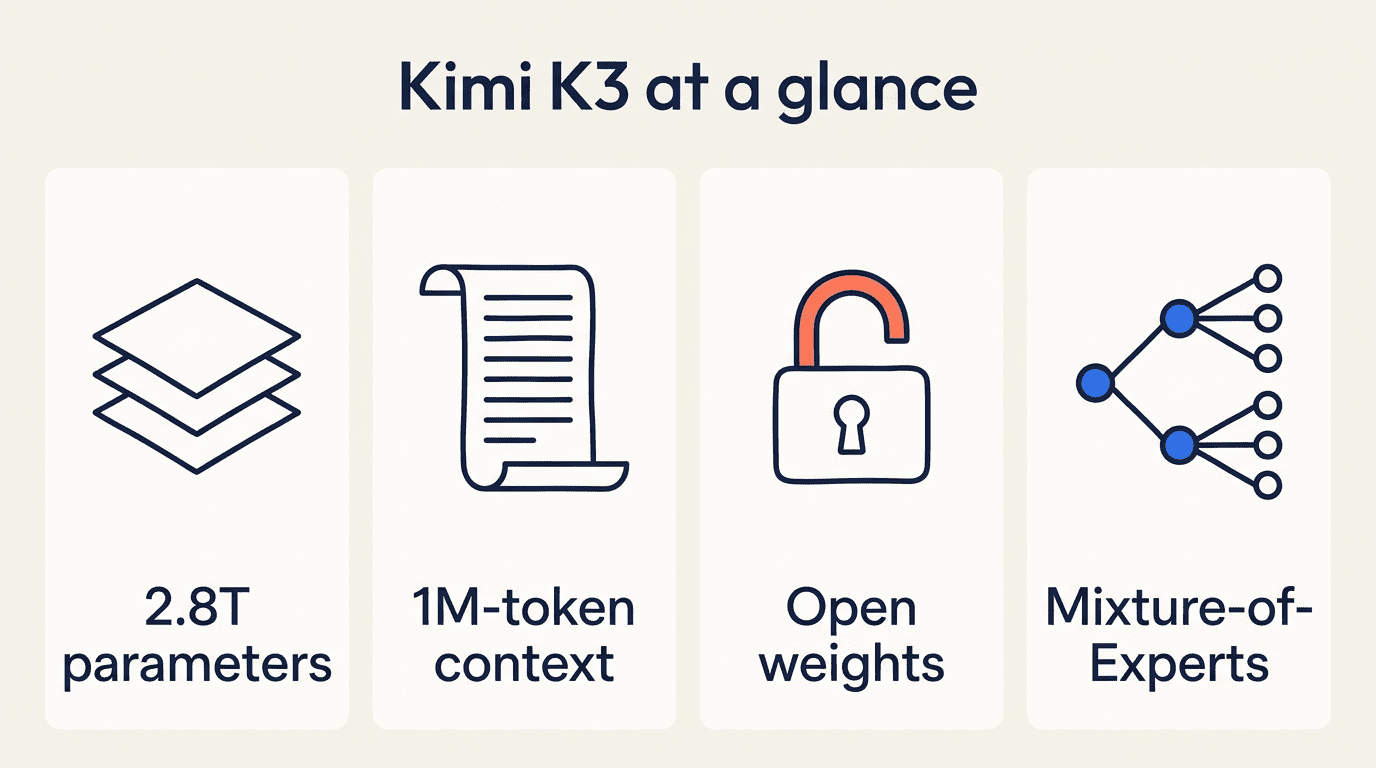
Quando le persone cercano “Kimi 3” intendono Kimi K3 — il modello linguistico di punta di Moonshot AI, lanciato il 16 luglio 2026. Secondo l’annuncio ufficiale di Moonshot AI, Kimi K3 è un sistema Mixture-of-Experts con circa 2,8 trilioni di parametri totali e una finestra di contesto da 1 milione di token, il che lo rende il più grande modello open-weight disponibile oggi.
Moonshot afferma che K3 è ancora dietro a Claude Fable 5 di Anthropic e GPT-5.6 Sol di OpenAI in termini generali, ma supera Claude Opus 4.8 e GPT-5.5 su alcuni benchmark di coding e agenti — a una frazione del prezzo. Questa guida spiega cos’è il modello, come si comporta, quanto costa e dove provarlo.
Cos’è Kimi K3?
Il modello e chi lo ha sviluppato
Kimi K3 è il modello di punta più capace di Moonshot AI fino ad oggi, lanciato il 16 luglio 2026 come successore della famiglia Kimi K2, che includeva:
- Kimi K2, la versione originale
- Kimi K2.5, un aggiornamento intermedio
- Kimi K2.6, un ulteriore perfezionamento
- Kimi K2.7 Code, una variante focalizzata sul coding
Moonshot AI è una startup di Pechino fondata nel 2023, nota soprattutto per il chatbot Kimi e per aver rilasciato K2 con una licenza Modified MIT. Quella precedente mossa open-weight spiega in parte l’attenzione suscitata dal lancio di K3: è la stessa azienda che punta ancora di più sulla condivisione dei pesi del modello mentre i concorrenti li tengono chiusi.
L’azienda è cresciuta rapidamente attorno a questa scommessa. Moonshot AI ha raccolto un round Series C nel gennaio 2026 a una valutazione di 4,3 miliardi di dollari, poi ha chiuso un ulteriore round da 2 miliardi di dollari nel maggio 2026 a una valutazione di 20 miliardi di dollari, con ricavi annui ricorrenti riportati superiori a 200 milioni di dollari.
Due varianti al lancio
K3 è stato rilasciato in due versioni: K3 Max, ottimizzato per le attività di chat e agenti, e K3 Swarm Max, sviluppato per l’elaborazione parallela su larga scala. Entrambi sono stati resi disponibili prima su Kimi Code e all’interno dell’app Kimi, inclusa la versione iOS. Tra i primi adottanti enterprise citati nella copertura del lancio figurano:
- Cursor, che ha integrato i modelli Kimi nel suo agente Composer 2
- DoorDash, già utente di Kimi prima del lancio di K3
- Thinking Machines, un altro early adopter dei modelli di Moonshot
Ognuna di queste aziende aveva già utilizzato modelli Kimi precedenti prima del lancio di K3, il che ha accorciato il percorso per testare il nuovo modello di punta.
Specifiche e architettura di Kimi K3
I numeri principali di Kimi K3 sono il conteggio dei parametri e la finestra di contesto, ma l’architettura sottostante è ciò che rende quei numeri utilizzabili su hardware reale.
Parametri e finestra di contesto
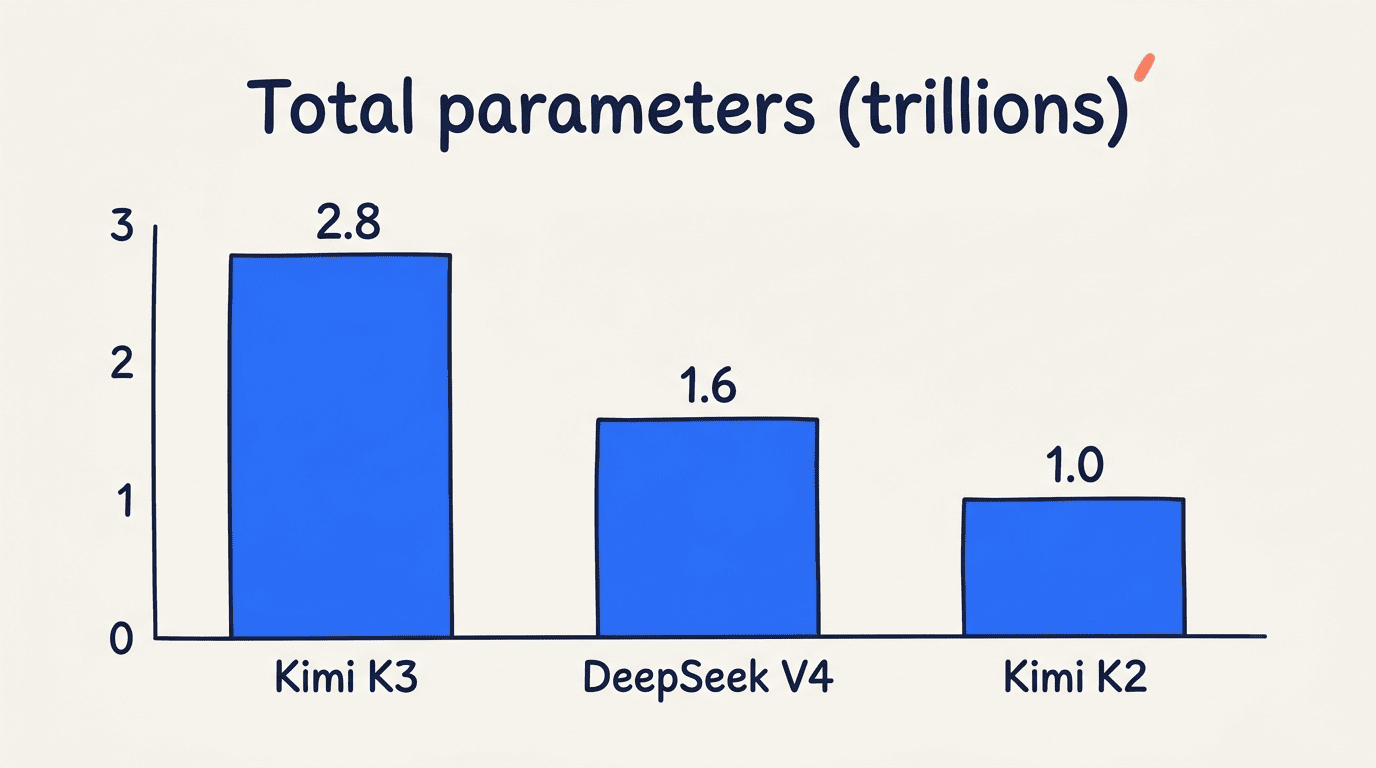
Kimi K3 conta 2,8 trilioni di parametri totali — il più grande LLM open-weight disponibile al lancio, anche se la copertura di Fortune citava una cifra leggermente inferiore di 2,7 trilioni. Accanto a quella scala si trova una finestra di contesto da 1 milione di token con comprensione visiva nativa, che permette a un singolo prompt di contenere un’intera codebase o un documento lungo come un libro senza suddividerlo in blocchi.
Moonshot non ha reso noto quanti di questi 2,8 trilioni di parametri siano attivi per token, che è il dato che determina effettivamente il costo e la velocità dell’inferenza. La tabella delle specifiche qui sotto riassume i numeri confermati pubblicamente da Moonshot.
| Specifica | Kimi K3 |
|---|---|
| Parametri totali | ~2,8 trilioni |
| Finestra di contesto | 1.000.000 token |
| Meccanismo di attenzione | Kimi Delta Attention (KDA) + Attention Residuals |
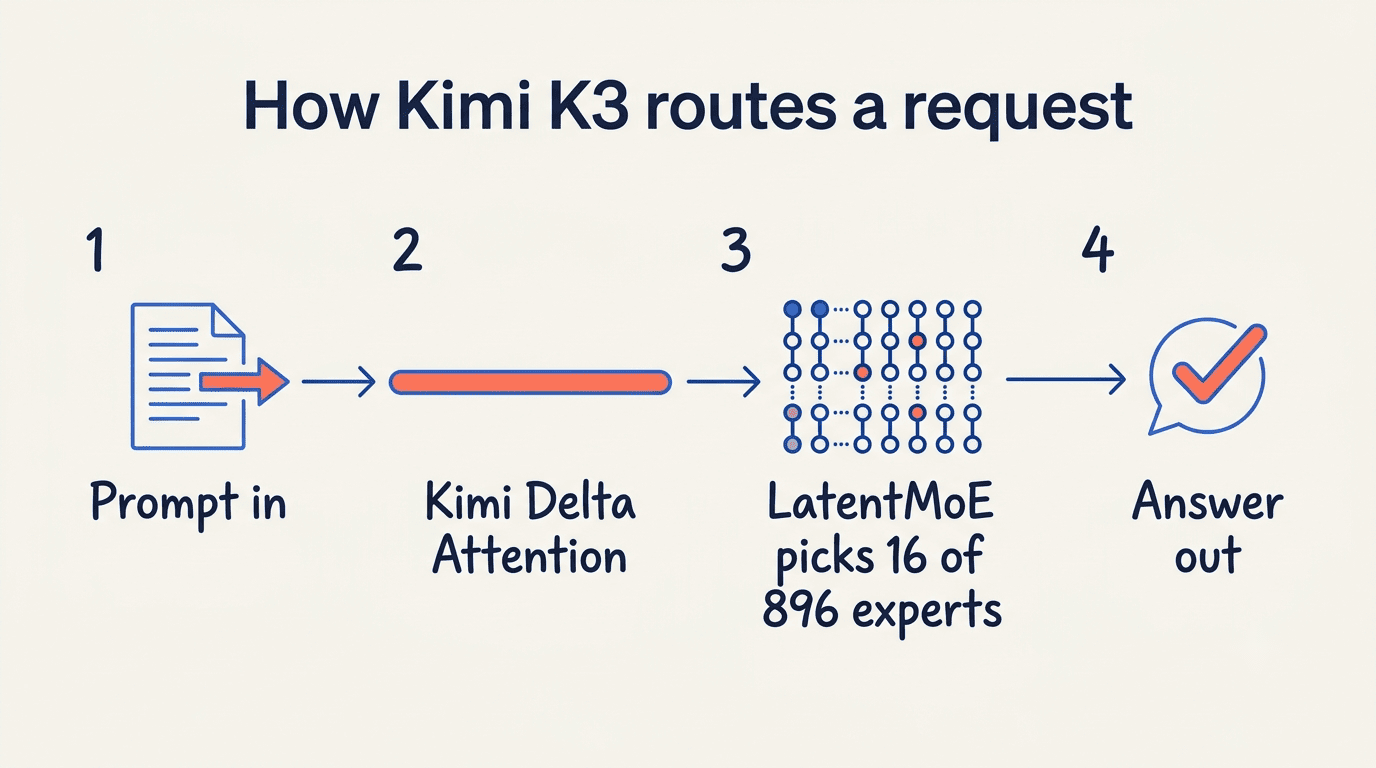
| Framework MoE | Stable LatentMoE, 16 esperti attivi su 896 per token |
| Supporto visione | Nativo |
| Efficienza di scaling vs K2 | ~2,5x |
| Varianti | K3 Max, K3 Swarm Max |
La nuova architettura: KDA + LatentMoE
Kimi K3 è costruito su Kimi Delta Attention (KDA), un meccanismo di attenzione lineare ibrido, combinato con ciò che Moonshot chiama Attention Residuals. Su questo si innesta il framework Stable LatentMoE — un perfezionamento del design Mixture-of-Experts sparso utilizzato dalla maggior parte dei grandi modelli oggi — che attiva solo 16 dei 896 esperti per token anziché eseguire l’intero conteggio dei parametri per ogni richiesta. Insieme, queste due scelte progettuali conferiscono a K3 un’efficienza di scaling circa 2,5 volte superiore a quella di K2 — trasformando una potenza di calcolo limitata in capacità utilizzabile sotto le restrizioni all’esportazione che limitano l’accesso ai chip più avanzati in Cina.
Quel ragionamento sull’efficienza conta più per Moonshot che per la maggior parte dei laboratori occidentali. I controlli sulle esportazioni di chip limitano la quantità di calcolo grezzo che un’azienda con sede a Pechino può acquistare, quindi ricavare maggiori capacità dallo stesso budget hardware è meno un’ottimizzazione e più una necessità di sopravvivenza per restare competitivi con rivali meglio finanziati.
Come si comporta Kimi K3 rispetto a Claude, GPT e DeepSeek
I confronti sui benchmark sono la parte di ogni lancio di un nuovo modello che i lettori seguono con più attenzione, e quelli di K3 sono volutamente contrastanti: forti in alcune aree, indietro in altre.
È dietro ai due attuali leader in termini generali. Nei benchmark pubblicati da Moonshot stessa, K3 è dietro a Claude Fable 5 e GPT-5.6 Sol nelle capacità generali. Moonshot non lo contesta — l’azienda presenta K3 come un modello che riduce il divario piuttosto che uno che guida in assoluto.
Supera i modelli della classe Opus e GPT-5.5 nel coding e negli agenti. Lo stesso insieme di benchmark mostra che K3 ha “superato significativamente” Claude Opus 4.8 e il modello gemello di GPT-5.6 Sol, GPT-5.5, nelle attività di coding e nei carichi di lavoro agentici generali, e ha ottenuto prestazioni “competitive” con Fable 5 in un sottoinsieme di test. I tester indipendenti che hanno avuto accesso anticipato hanno collocato le sue prestazioni pratiche di coding attorno al livello di Opus 4.8.
I numeri vengono con una precisazione. Questi benchmark sono stati curati ed eseguiti da Moonshot stessa. Le valutazioni indipendenti su suite standard come SWE-Bench Verified e Terminal-Bench 2.1 sono ancora in attesa del rilascio dei pesi open, quindi il confronto va interpretato come indicativo piuttosto che definitivo. DeepSeek V4, un altro modello open-weight cinese spesso confrontato con K3, opera a circa 1,6 trilioni di parametri — più piccolo di K3 ma con un prezzo molto inferiore.
Kimi K3 è il nostro modello open-weight più capace fino ad oggi, progettato per colmare il divario con i sistemi frontier chiusi a una frazione del loro costo.Moonshot AI, annuncio ufficiale di K3
La reazione al di là delle tabelle dei benchmark è stata immediata nei mercati cinesi il giorno dell’annuncio di K3:
- Le azioni di Z.ai sono scese di quasi il 30% nelle contrattazioni di Hong Kong
- Le azioni di MiniMax sono calate di circa il 16%
- Nvidia ha perso circa il 2%
- Il Nikkei giapponese ha chiuso in calo del 4% e il mercato taiwanese è sceso di oltre il 6%, per via di rinnovate preoccupazioni sull’efficienza
Prezzi di Kimi K3 e pesi aperti
Prezzo API
L’API di Kimi K3 è prezzata a $15 per milione di token in output, $0,30 per milione di token in input con cache hit e $3,00 per milione di token in input senza cache (standard), su base pay-as-you-go senza livelli basati sulla lunghezza del contesto. È costoso per gli standard cinesi — GLM-5.2 di z.ai costa $4,40 per milione di token in output e DeepSeek V4 costa $0,87 — ma rimane molto al di sotto dei $50 per milione di token in output di Claude Fable 5.
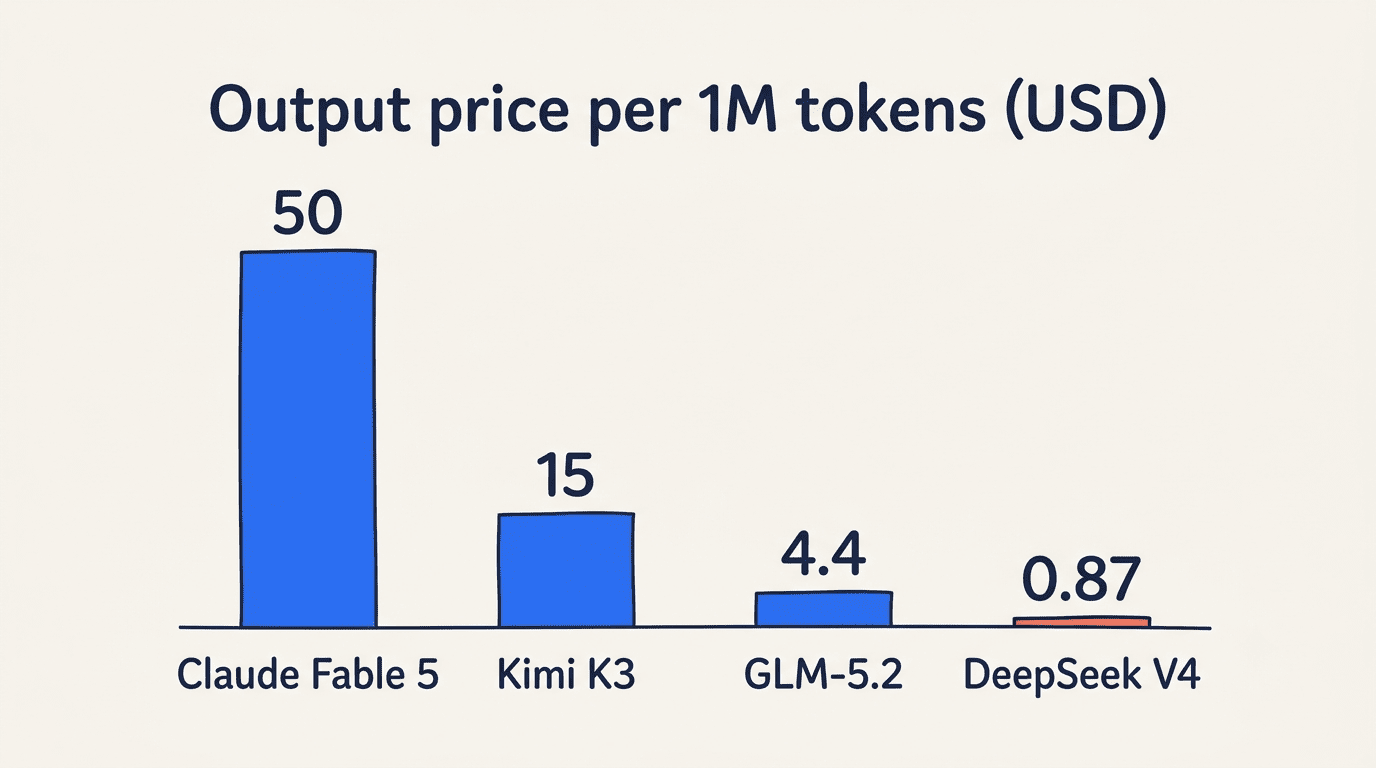
Una tariffazione flat e non a livelli semplifica anche la pianificazione del budget per i team che sviluppano sull’API: una richiesta con contesto lungo che riempie l’intera finestra da 1 milione di token ha lo stesso costo per token di una breve, a differenza dei provider che applicano tariffe più alte una volta superata una soglia di lunghezza del prompt.
| Modello | Prezzo output (per 1M token) |
|---|---|
| Claude Fable 5 | $50.00 |
| Kimi K3 | $15.00 |
| GLM-5.2 (z.ai) | $4.40 |
| DeepSeek V4 | $0.87 |
Pesi aperti il 27 luglio 2026
Kimi K3 è un modello open-weight. Moonshot ha dichiarato che i pesi completi saranno rilasciati entro il 27 luglio 2026, seguendo il precedente della licenza Modified MIT stabilito con K2. Una volta che i pesi saranno scaricabili, le aziende potranno fare fine-tuning di K3 sulla propria infrastruttura — la stessa dinamica che ha contribuito a rendere i modelli Meta’s Llama una scelta predefinita per i deployment interni.
Esistono tre modalità di accesso fianco a fianco per singoli e team:
- Fatturazione API pay-as-you-go alle tariffe per token indicate sopra
- Un abbonamento mensile da ¥199 per l’accesso solo tramite app, senza API
- Self-hosting dei pesi aperti gratuitamente una volta rilasciati il 27 luglio 2026
Dove e come provare Kimi K3
Non è necessario avere accesso API per utilizzare Kimi K3 — la maggior parte delle piattaforme qui sotto è accessibile gratuitamente da un browser.
- Aprire kimi.com nel browser per provare K3 nell’interfaccia di chat web di Moonshot.
- Installare l’app Kimi su iOS (o usare la versione web) per lo stesso modello su mobile.
- Provare Kimi Code se il compito è un flusso di lavoro di coding o agente piuttosto che una chat aperta.
- Provare Kimi Work per attività orientate ai documenti e all’area di lavoro.
- Iscriversi per l’accesso API sulla piattaforma per sviluppatori — le nuove registrazioni sono attualmente aperte.
- Puntare un SDK compatibile con OpenAI all’endpoint di Moonshot, impostando
model="kimi-k3"ebase_url="https://api.moonshot.ai/v1". - Lasciare attiva la modalità thinking — è abilitata per impostazione predefinita su K3 e attualmente non può essere disattivata.
Tutto a partire dal punto 5 utilizza la stessa chiave API e fatturazione della tabella dei prezzi sopra, quindi testare tramite SDK è il modo più rapido per confrontare il vero output di K3 con qualsiasi modello già in uso in produzione.
Kimi K3 vs Kimi K2: cosa è cambiato
Confronto affiancato
La famiglia Kimi K2 — che comprende K2, K2.5, K2.6 e K2.7 Code — operava con 1 trilione di parametri totali, 32 miliardi attivi per token, una finestra di contesto da 256.000 token e una licenza Modified MIT. Kimi K3 triplica approssimativamente il conteggio totale dei parametri a 2,8 trilioni, quadruplica la finestra di contesto a 1 milione di token e sostituisce il design dell’attenzione di K2 con la nuova architettura KDA-plus-LatentMoE mirata specificamente ai carichi di lavoro agentici a lungo orizzonte.
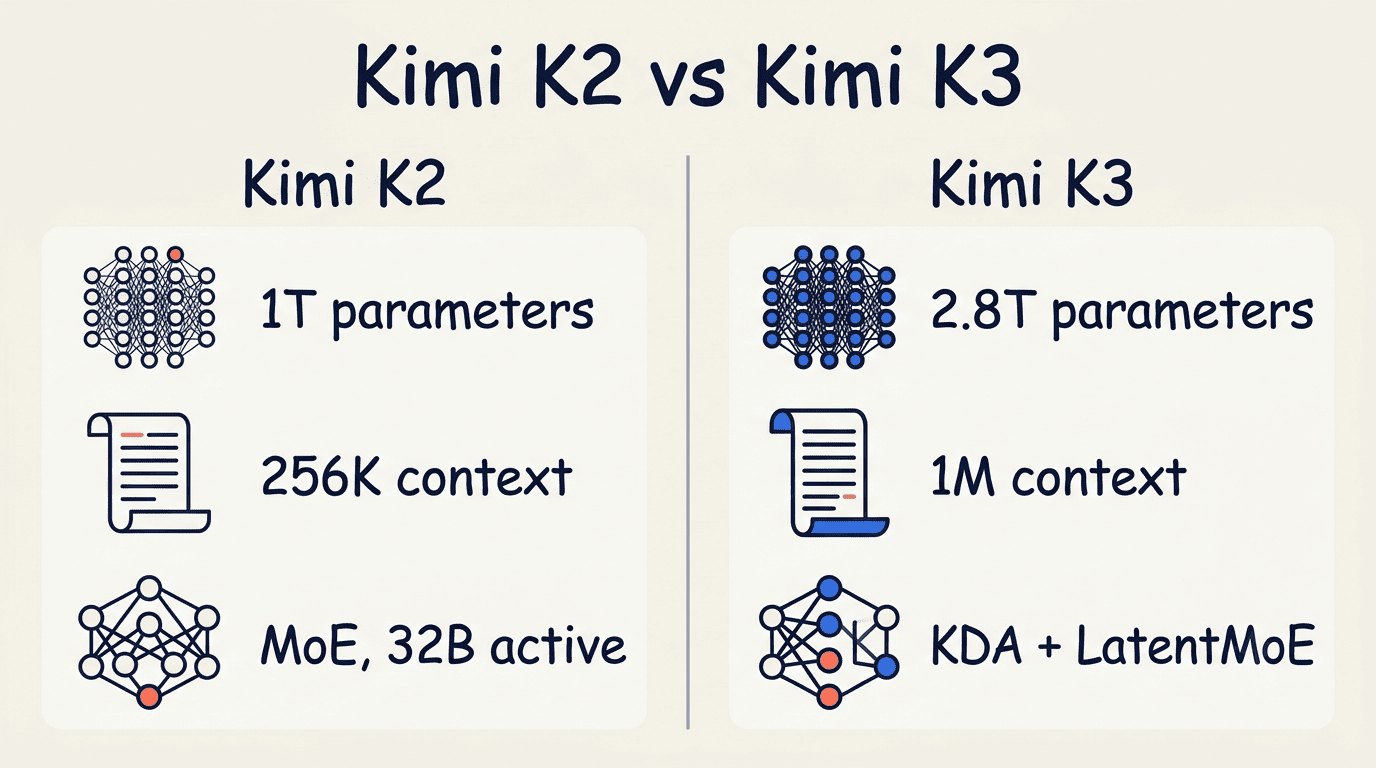
È un salto sia nella scala grezza che nella lunghezza del contesto, non un semplice aumento di scala della stessa architettura — ed è anche per questo che Moonshot descrive il guadagno di efficienza come circa 2,5x piuttosto che una funzione puramente della dimensione.
Per chi esegue già K2 in produzione, il percorso di aggiornamento pratico riguarda il nome del modello e il limite della finestra di contesto: le integrazioni esistenti compatibili con l’SDK OpenAI nella maggior parte dei casi richiedono solo la sostituzione con model="kimi-k3", anche se i prompt costruiti attorno al limite da 256K token di K2 possono ora essere riprogettati attorno a un contesto di lavoro molto più ampio.
FAQ
Cos’è Kimi K3?
Il modello LLM di punta di nuova generazione di Moonshot AI, un modello Mixture-of-Experts con circa 2,8 trilioni di parametri e una finestra contestuale di 1 milione di token, lanciato il 16 luglio 2026.
Quando è stato rilasciato Kimi K3?
Il 16 luglio 2026, come successore della famiglia Kimi K2 (K2, K2.5, K2.6, K2.7 Code).
Quanti parametri ha Kimi K3?
Circa 2,8 trilioni di parametri totali (Fortune ha citato 2,7 trilioni), il che lo rende il più grande modello open-weight disponibile. Moonshot non ha divulgato il numero di parametri attivi.
Kimi K3 è open source?
È stato lanciato come modello open-weight, con il rilascio completo dei pesi previsto per il 27 luglio 2026, seguendo il precedente della licenza MIT modificata stabilito da K2.
Quanto costa Kimi K3?
$15 per milione di token in output e $0,30 per milione di token in input con cache-hit — più economico dei $50 di Claude Fable 5, più costoso degli $0,87 di DeepSeek V4. È disponibile anche un piano in abbonamento mensile a ¥199.
Qual è la finestra contestuale di Kimi K3?
1 milione di token, con comprensione visiva nativa — abbastanza da contenere un’intera codebase o un documento della lunghezza di un libro in un unico prompt.
Come si confronta Kimi K3 con Claude e GPT?
Nei benchmark ufficiali di Moonshot, risulta inferiore a Claude Fable 5 e GPT-5.6 Sol nel complesso, ma supera Claude Opus 4.8 e GPT-5.5 in alcuni compiti di programmazione e di agente. I benchmark indipendenti sono ancora in attesa.