Cos’è Kimi Delta Attention (KDA)? La Regola Delta con Gate per Canale Spiegata
Kimi Delta Attention (KDA) è un meccanismo di attenzione lineare che perfeziona la regola delta con gate attraverso un gating granulare per singolo canale, consentendo a una memoria ricorrente compatta di gestire contesti lunghi a basso costo. Moonshot AI lo ha introdotto nel paper Kimi Linear come nucleo di attenzione alla base di Kimi K3, il modello di punta dell’azienda, dove sostituisce la maggior parte dei livelli di attenzione completa standard che un grande modello linguistico richiederebbe altrimenti. Il risultato è un design ibrido che mantiene una qualità paragonabile all’attenzione completa utilizzando una frazione della memoria.
Questo compromesso è rilevante perché la memoria per l’attenzione — non la potenza di calcolo grezza — è spesso il fattore che limita l’ampiezza pratica della finestra di contesto che un modello può gestire. KDA affronta direttamente quel collo di bottiglia — e puoi metterlo alla prova in una chat live su bota.chat.
KDA in una frase
KDA perfeziona la regola delta con gate attraverso un gating granulare per singolo canale, così una memoria ricorrente compatta può gestire contesti lunghi a basso costo. Invece di conservare un elenco crescente di coppie chiave-valore passate come fa l’attenzione standard, KDA comprime tutto ciò che ha elaborato finora in uno stato di dimensione fissa e lo aggiorna un token alla volta. Ogni aggiornamento decide, a livello di singoli canali di feature, cosa conservare e cosa sovrascrivere — una distinzione che lo differenzia sia dalla semplice attenzione lineare sia dal suo predecessore diretto, Gated DeltaNet.
Dall’attenzione quadratica alla regola delta
L’attenzione softmax standard confronta ogni token con tutti gli altri token di una sequenza, quindi il suo costo cresce quadraticamente con la lunghezza della sequenza — raddoppiare la finestra di contesto quadruplica il lavoro. L’attenzione lineare rompe questa scalabilità: invece di una tabella crescente di chiavi e valori passati, mantiene uno stato di dimensione fissa che si aggiorna man mano che arrivano nuovi token, così il costo cresce linearmente.
La regola delta come memoria associativa
La regola delta tratta quello stato di dimensione fissa come una memoria associativa — una tabella di ricerca compressa in una matrice. A ogni passo, il modello scrive una nuova associazione chiave-valore nello stato e, prima di farlo, rimuove qualsiasi vecchia associazione presente in quella chiave. Questo schema “cancella, poi scrivi” è ciò a cui si riferisce “delta”: l’aggiornamento è la differenza tra ciò che dovrebbe esserci e ciò che c’è già, non un’accumulazione cieca di tutto quanto visto finora.
Perché l’attenzione lineare semplice aveva bisogno di un meccanismo di dimenticanza
Senza un modo per dimenticare, una memoria di dimensione fissa si satura alla fine — informazioni vecchie e nuove si sovrascrivono a vicenda in modi che distruggono il contesto precedente. Alcuni meccanismi hanno affrontato questo problema, ognuno aggiungendo un gate che decide quanta parte dello stato precedente conservare a ogni passo:
- Gated Linear Attention (GLA) aggiunge un gate di dimenticanza alla semplice attenzione lineare, senza l’aggiornamento cancella-poi-scrivi della regola delta.
- Mamba2 usa un singolo decadimento scalare applicato a un intero blocco di canali — semplice e veloce, ma grossolano.
- Gated DeltaNet (GDN) abbina la regola delta a un gate di dimenticanza applicato una volta per ogni testa di attenzione.
- KDA porta oltre la combinazione di GDN, spostando quel gate ai singoli canali di feature.
Il gate per testa di GDN è l’antenato diretto di KDA — l’ultima tappa prima che il gating diventasse abbastanza fine da essere per canale.
Gating per canale: cosa rende KDA diverso
Il gate di dimenticanza di GDN è per testa. L’architettura Gated DeltaNet applica un singolo tasso di dimenticanza scalare per testa di attenzione, così ogni dimensione di feature all’interno di quella testa decade alla stessa velocità indipendentemente da ciò che rappresenta.
KDA assegna a ogni canale il proprio tasso di dimenticanza. Invece di un unico valore di decadimento per testa, KDA calcola un gate separato per ogni canale di feature all’interno di una testa, così alcuni canali conservano le informazioni per molti passi mentre canali adiacenti nella stessa testa decadono rapidamente.
Quella precisione deriva da un aggiornamento Diagonale-Più-Basso-Rango. Il gate per canale di KDA è strutturato come una matrice di transizione Diagonale-Più-Basso-Rango (DPLR) — un termine diagonale gestisce il decadimento per canale mentre un termine di basso rango cattura le interazioni tra canali, mantenendo l’aggiornamento economico nonostante la granularità aggiuntiva.
| Meccanismo | Granularità del gating | Aggiornamento dello stato |
|---|---|---|
| Mamba2 | Scalare, condiviso su un blocco di canali | Decadimento diagonale |
| Gated DeltaNet (GDN) | Un gate scalare per testa di attenzione | Regola delta + gate per testa |
| Kimi Delta Attention (KDA) | Un gate per canale di feature | Regola delta + gate DPLR per canale |
La granularità aggiuntiva non è gratuita — comporta più valori di gate per passo — ma si ripaga precisamente nei carichi di lavoro che dipendono dall’estrarre un dettaglio specifico da un contesto lungo piuttosto che riassumerlo in modo generale:
- Risposta a domande su documenti lunghi, dove la risposta dipende da una singola frase sepolta lontano nell’input
- Ricerca in più file di codice, dove una variabile definita all’inizio di un repository deve essere ricordata accuratamente molto più tardi
- Memoria degli agenti nel corso di sessioni lunghe, dove un fatto enunciato una volta deve sopravvivere a molti turni successivi
- Benchmark di recupero ago-nel-pagliaio come RULER
Un gate più grossolano perde precisione prima esattamente in questi compiti.
L’ibrido: KDA + attenzione completa in un rapporto 3:1
Kimi Linear, l’architettura costruita attorno a KDA, non sostituisce completamente l’attenzione completa — le due si alternano, con ogni blocco di livelli suddiviso come segue:
- Tre livelli di KDA, che gestiscono la maggior parte dell’elaborazione delle sequenze con uno stato di dimensione fissa aggiornato a basso costo
- Un livello di Multi-head Latent Attention (MLA), la stessa variante di attenzione con cache KV compressa su cui Moonshot fa già affidamento altrove nei suoi modelli
Quel singolo livello MLA offre al modello uno sguardo completo e non compresso sull’intero contesto ogni volta che il rapporto lo prevede, mentre i livelli KDA circostanti mantengono basso il costo per token. Poiché la maggior parte dei livelli usa lo stato di dimensione fissa di KDA invece di memorizzare coppie chiave-valore per ogni token, l’architettura riduce l’utilizzo della cache KV del 75% rispetto a un modello costruito interamente con attenzione completa, e raggiunge fino a 6x di throughput di decodifica a una lunghezza di contesto di 1 milione di token. Nel benchmark RULER per contesti lunghi a 128.000 token, l’ibrido ha ottenuto l’84,3% contro l’81,3% di una baseline con attenzione completa — prova che il risparmio di memoria non ha compromesso l’accuratezza del recupero.
| Metrica (a contesto di 1M token) | Attenzione completa | Ibrido KDA (3:1) |
|---|---|---|
| Utilizzo cache KV | Baseline | -75% |
| Throughput di decodifica | Baseline | fino a 6x |
| RULER @ 128k | 81,3% | 84,3% |
Questi dati provengono dal report tecnico di Moonshot e non da un benchmark indipendente — un aspetto da tenere presente quando si valuta quanto siano direttamente trasferibili a un carico di lavoro diverso.
Kimi Linear supera l’attenzione completa con un margine considerevole su tutti i compiti valutati, riducendo al contempo l’utilizzo della cache KV fino al 75% e offrendo fino a 6x di throughput di decodifica a una lunghezza di contesto di 1M.Kimi Team, “Kimi Linear: An Expressive, Efficient Attention Architecture”
Chiunque voglia valutare se vale la pena adottare un design di attenzione ibrida per un determinato carico di lavoro può seguire la stessa checklist che i confronti di Moonshot seguono implicitamente:
- Verificare la lunghezza del contesto rilevante per il carico di lavoro. I vantaggi di efficienza dell’attenzione lineare si amplificano con la crescita del contesto, quindi i casi d’uso con prompt brevi traggono meno beneficio di quelli da un milione di token.
- Cercare un dato sulla cache KV, non solo un conteggio dei parametri. La dimensione della cache, non il numero totale di parametri, determina la pressione sulla memoria al momento del serving.
- Chiedersi quale frazione dei livelli usa ancora l’attenzione completa. Un rapporto 3:1 come quello di Kimi Linear è un compromesso deliberato, non l’unica opzione.
- Esigere un benchmark di qualità come-per-come, non solo un dato di velocità. I guadagni di throughput contano poco se l’accuratezza del recupero cala.
- Verificare la granularità del meccanismo di gating. I gate più grossolani sono più economici per passo; quelli più fini costano di più ma tendono a preservare un recupero a lungo raggio più preciso.
Dove si inserisce KDA nel modello più grande
KDA è una scelta a livello di layer di attenzione, e si affianca a una scelta architetturale separata riguardante il modo in cui un modello instrada il calcolo tra i suoi parametri: il routing sparse mixture of experts (MoE). I due rispondono a domande diverse sullo stesso modello:
- Attenzione (il compito di KDA) — come il modello ricorda e recupera il contesto da punti precedenti della sequenza
- Routing MoE (un compito separato) — quanta parte del totale dei parametri del modello si attiva per un dato token
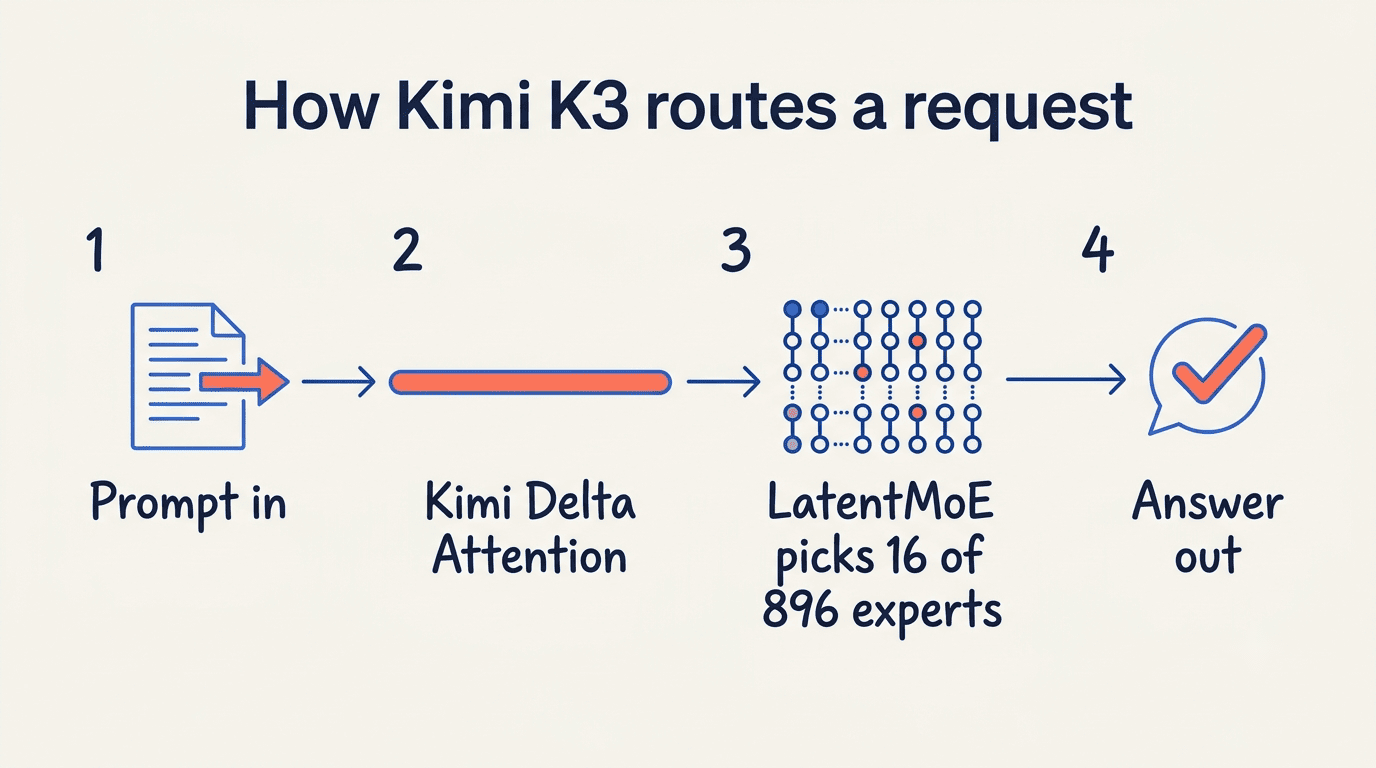
Poiché si tratta di assi di progettazione indipendenti, un modello può combinare un meccanismo di attenzione efficiente come KDA con un meccanismo di routing efficiente come MoE senza che nessuno dei due vincoli l’altro. La stessa logica di rapporto ibrido e gating per canale potrebbe, in linea di principio, essere integrata in un modello denso o in una configurazione MoE completamente diversa — ed è per questo che i lettori che confrontano modelli AI open-weight rispetto a open-source incontreranno di nuovo KDA ogni volta che un laboratorio pubblica sia i propri pesi sia i dettagli architetturali che li sottendono.
FAQ
Che cos’è Kimi Delta Attention?
Un meccanismo di attenzione lineare che affina la regola delta con gate a livello di canale, consentendo a uno stato ricorrente di dimensione fissa di gestire contesti lunghi a un costo molto inferiore rispetto alla full attention standard.
In cosa differisce KDA da Gated DeltaNet?
Gated DeltaNet applica un unico forget gate per ogni testa di attenzione, quindi tutti i canali di quella testa decadono alla stessa velocità. KDA calcola un gate separato per ogni canale di feature, ottenendo un controllo molto più preciso su ciò che la memoria trattiene.
Che cos’è la regola delta nell’attenzione lineare?
Una regola di aggiornamento che tratta uno stato di dimensione fissa come memoria associativa: a ogni passo rimuove l’associazione precedente memorizzata per una data chiave prima di scrivere quella nuova, invece di accumulare semplicemente informazioni senza mai cancellarle.
Perché KDA utilizza il gating per canale?
Perché un unico tasso di decadimento per testa è troppo grossolano — diversi canali di feature spesso devono dimenticare a velocità diverse. Il gating per canale, implementato tramite un aggiornamento Diagonal-Plus-Low-Rank, consente a ogni canale di mantenere o scartare le informazioni in modo indipendente.
KDA sostituisce completamente la full attention?
No. Kimi Linear alterna KDA e full attention in un rapporto 3:1, utilizzando la Multi-head Latent Attention per i livelli rimanenti, così il modello ottiene comunque una visione periodica e non compressa dell’intero contesto.