Cos’è un modello Mixture-of-Experts (MoE)? Una guida in parole semplici
Un modello mixture of experts (MoE) è una rete neurale composta da numerose sotto-reti specializzate, chiamate esperti, più un piccolo router che decide quali esperti gestiscono ogni porzione dell’input. Invece di eseguire ogni parametro su ogni token, come descrive la voce di Wikipedia dedicata all’architettura, un modello MoE attiva solo un piccolo gruppo di esperti per token — ed è per questo che MoE è diventata l’architettura predefinita per i modelli linguistici più grandi che si addestrano oggi.
L’idea non è nuova, ma ci è voluto un decennio di lavoro di scaling per renderla pratica. In questa guida di bota.chat: cosa significa MoE, come decide il router, perché “sparse” è la parola chiave, e come i modelli più avanzati mettono l’idea in pratica.
Cosa significa davvero “Mixture of Experts”
Nella sua essenza, un modello MoE sostituisce un singolo grande blocco feed-forward all’interno di un transformer con diverse sotto-reti feed-forward più piccole disposte in parallelo. Ogni sotto-rete è chiamata esperto e, nonostante il nome, nessun esperto viene addestrato a “conoscere” una materia specifica come la grammatica o la matematica — gli esperti si specializzano su pattern che emergono naturalmente durante l’addestramento, come certi tipi di token o determinati passaggi di ragionamento.
Il concetto risale al 1991, quando Jacobs, Jordan, Nowlan e Hinton pubblicarono “Adaptive Mixtures of Local Experts” sulla rivista Neural Computation, descrivendo un sistema che suddivideva un compito tra diverse reti combinate tramite un meccanismo di gating separato. Quel progetto è un diretto antenato dell’architettura mixture-of-experts usata oggi nei large language model, sebbene la scala sia cresciuta di diversi ordini di grandezza.
Un modello mentale utile: immagina il banco accettazione di un ospedale. Non cura direttamente ogni paziente — legge i sintomi e invia il paziente ai due o tre specialisti più adatti al caso, mentre il resto del personale rimane libero per gli altri. Quel banco accettazione è il router, il secondo elemento di qualsiasi modello MoE.
Ogni livello mixture-of-experts è costruito dagli stessi elementi:
- Un insieme di esperti — sotto-reti feed-forward più piccole in parallelo.
- Un router (rete di gating) — assegna un punteggio a ogni esperto e sceglie quali attivare.
- Una fase di combinazione — unisce gli output degli esperti selezionati.
- Facoltativamente, un esperto condiviso che rimane attivo per ogni token.
Come il router sceglie gli esperti
Il router, talvolta chiamato rete di gating, è un piccolo componente addestrabile posizionato davanti all’insieme degli esperti. Per ogni token, calcola un punteggio per ciascun esperto e seleziona i migliori — un metodo noto come top-k routing. I valori tipici di k vanno da uno o due esperti nei progetti precedenti fino a qualche decina nelle architetture sparse più recenti.
Questo instradamento avviene per token, non per sequenza. Una singola frase può inviare la prima parola a un insieme di esperti e la quinta parola a un insieme completamente diverso, tutto nell’ambito dello stesso forward pass. I punteggi del router vengono appresi insieme al resto della rete, così la divisione del lavoro emerge dai dati di addestramento anziché essere progettata a mano. Mantenere quella divisione bilanciata — in modo che un pugno di esperti non assorba la maggior parte del traffico mentre gli altri rimangono inattivi — è uno dei problemi ingegneristici più difficili nella costruzione di un modello MoE, di solito affrontato con una loss ausiliaria di bilanciamento del carico durante l’addestramento.
Solo gli esperti selezionati eseguono il calcolo per quel token, mentre i pesi degli altri esperti della rete rimangono inattivi. Questa attivazione selettiva è ciò che distingue MoE da un’architettura densa convenzionale ed è l’intera ragione per cui l’approccio scala in modo così efficiente.
Una singola decisione di instradamento si svolge così:
- Il router riceve la rappresentazione nascosta del token.
- Assegna un punteggio a ogni esperto nel livello.
- Classifica i punteggi e mantiene i top-k esperti.
- Ogni esperto selezionato elabora il token in modo indipendente.
- Il router combina gli output, ponderati dai rispettivi punteggi.
Parametri attivi vs parametri totali (perché MoE è “sparse”)
I modelli MoE vengono descritti usando due conteggi di parametri invece di uno: parametri totali e parametri attivi. I parametri totali contano ogni peso in tutti gli esperti, inclusi quelli non utilizzati per un dato token. I parametri attivi contano solo i pesi toccati durante il forward pass di quel token — il router più il piccolo sottoinsieme di esperti che ha selezionato.
Questo divario tra i due numeri è il motivo per cui si applica il termine “sparse”. Un modello può portare centinaia di miliardi di parametri totali per immagazzinare una capacità ampia e variegata, pur spendendo una potenza di calcolo più vicina a quella di un modello denso molto più piccolo per ogni singolo token. La tabella seguente illustra il pattern con valori rappresentativi a titolo indicativo.
| Tipo di modello | Parametri totali | Parametri attivi per token | Calcolo per token |
|---|---|---|---|
| Modello denso | 70B | 70B (100%) | Alto, fisso |
| Modello sparse MoE | 400B+ | ~30-40B (meno del 10%) | Basso, variabile |
Poiché solo una frazione della rete si attiva per token, gli ingegneri possono aumentare la capacità totale senza un proporzionale aumento del costo di inferenza — un compromesso che conta direttamente per il tipo di ragionamento su contesti lunghi trattato nella nostra analisi della finestra di contesto da 1M di token, dove il costo per token ha un impatto sproporzionato su ciò che è utilizzabile in produzione.
MoE vs modelli densi
Un modello denso attiva ogni parametro per ogni token, senza eccezioni. Questa uniformità rende i modelli densi più semplici da analizzare, ma il costo scala linearmente con la dimensione: raddoppiare il numero di parametri raddoppia all’incirca il calcolo per token.
Dove i modelli densi vincono ancora
Le architetture dense evitano l’overhead di instradamento e i problemi di bilanciamento del carico di una rete di gating. I modelli densi più piccoli sono anche più facili da mettere a punto in modo prevedibile, poiché ogni parametro vede ogni esempio di addestramento.
Dove MoE prende il sopravvento
I modelli MoE disaccoppiano la capacità dal costo: un modello sparse ben calibrato può eguagliare o superare un modello denso di dimensioni molte volte maggiori rispetto ai parametri attivi, poiché il pool totale di parametri immagazzina molte più conoscenze senza pagarle a ogni passaggio. Il compromesso è una complessità aggiuntiva — logica di instradamento, bilanciamento del carico e overhead di comunicazione tra l’hardware.
| Fattore | Modello denso | Modello MoE |
|---|---|---|
| Calcolo per token | Fisso, scala con la dimensione completa | Minore, scala solo con gli esperti attivi |
| Complessità di addestramento | Più semplice, nessun instradamento | Maggiore, richiede bilanciamento del carico |
| Scalabilità della capacità | Costosa da aumentare | Più economica per aumentare i parametri totali |
| Adatto a | Attività piccole e sensibili alla latenza | I modelli flagship più grandi |
Come hanno scritto Noam Shazeer e i suoi coautori nell’articolo che ha riportato in vita l’architettura per il deep learning:
Introduciamo uno strato mixture-of-experts con gating sparso (MoE), composto da fino a migliaia di sotto-reti feed-forward. Una rete di gating addestrabile determina una combinazione sparsa di questi esperti da utilizzare per ogni esempio.Shazeer et al., “Outrageously Large Neural Networks” (arXiv:1701.06538)
Modelli MoE nel mondo reale
La genealogia moderna dei modelli linguistici mixture-of-experts inizia con l’articolo del 2017 “Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer,” che dimostrava come l’inserimento di uno strato MoE tra livelli LSTM potesse scalare la capacità del modello di oltre 1.000 volte con solo lievi aumenti del calcolo — uno schema che quasi tutti i successivi modelli linguistici MoE hanno seguito.
Un breve elenco di tappe fondamentali mostra quanto rapidamente l’architettura si sia maturata:
- 1991 — Adaptive Mixtures of Local Experts introduce il concetto di gating.
- 2017 — Lo Sparsely-Gated MoE Layer lo applica all’interno di reti LSTM profonde su larga scala.
- 2021 — Switch Transformer instrada verso un singolo esperto per token, addestrando un modello oltre il trilione di parametri.
- 2023-2024 — Mixtral diffonde i modelli sparse MoE open-weight; la linea MoE di DeepSeek introduce separatamente un esperto condiviso che rimane attivo accanto a quelli instradati.
- 2024-2026 — I lab di frontiera adottano MoE come standard per i loro modelli più grandi.
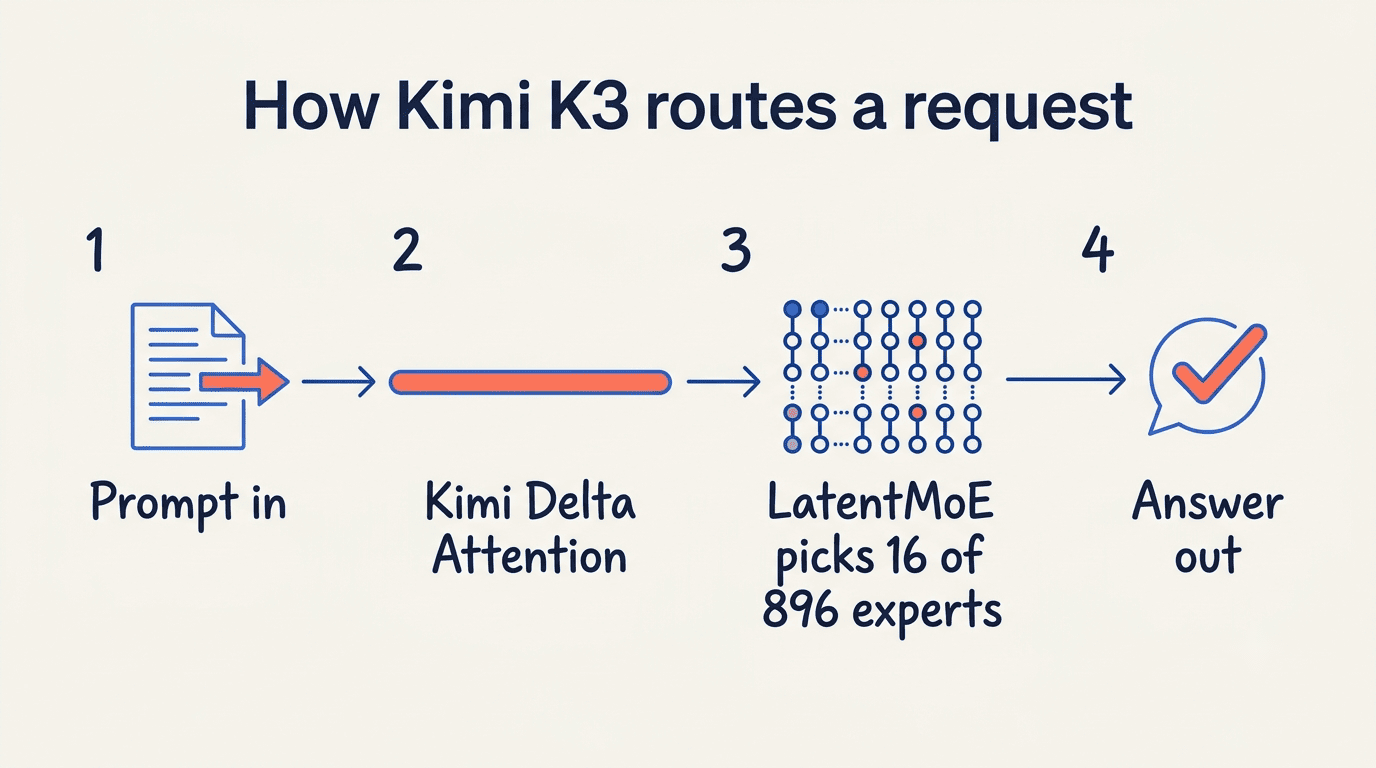
Il modello flagship di Moonshot AI è un esempio attuale di questa traiettoria. La sua architettura LatentMoE instrada ogni token verso soli 16 dei 896 esperti disponibili, mantenendo basso il calcolo attivo mentre la capacità totale rimane enorme — un design approfondito ulteriormente nella guida a Kimi K3 di Moonshot. L’azienda dietro quell’architettura, presentata nella nostra panoramica su Moonshot AI, ha costruito il proprio programma di ricerca attorno a portare il routing sparso oltre i precedenti rilasci aperti.
Non tutti i modelli di grandi dimensioni seguono questo percorso — alcuni laboratori preferiscono ancora architetture dense per deployment più piccoli e sensibili alla latenza, riservando MoE ai rilasci flagship. I fili conduttori comuni tra i rilasci MoE includono:
- Un router addestrato congiuntamente con gli esperti.
- Un meccanismo di bilanciamento del carico per prevenire il collasso degli esperti.
- Un divario significativo tra il conteggio dei parametri totali e quelli attivi.
- Almeno un esperto condiviso o sempre attivo nei design più recenti.
FAQ
Cos’è un mixture of experts in parole semplici?
Una rete neurale composta da sotto-reti più piccole (esperti) e da un router che seleziona pochi esperti pertinenti per ogni input, invece di utilizzare l’intera rete ogni volta.
Come funziona il router in un modello MoE?
Assegna un punteggio a ogni esperto disponibile per ciascun token e seleziona i migliori (top-k routing). Gli esperti selezionati elaborano il token; gli altri rimangono inattivi.
Qual è la differenza tra parametri attivi e parametri totali?
I parametri totali contano ogni peso del modello, inclusi gli esperti non utilizzati. I parametri attivi contano solo i pesi impiegati per un singolo token — di solito una piccola frazione del totale.
Un modello MoE è migliore di un modello denso?
MoE offre maggiore capacità per unità di calcolo, poiché per ogni token viene eseguito solo un sottoinsieme di esperti. I modelli densi rimangono più semplici da addestrare, il che li rende ancora adatti a casi d’uso di dimensioni ridotte o sensibili alla latenza.
Quali sono esempi di modelli mixture-of-experts?
Switch Transformer, Mixtral e il modello di punta LatentMoE di Moonshot AI (che instrada verso 16 dei 896 esperti) sono esempi ampiamente citati tra i modelli linguistici in produzione.