ChatGPT Images 2.5: What’s New in OpenAI’s State-of-the-Art Image Model
На 8 септември 2026 г. OpenAI пусна ChatGPT Images 2.5 — следващото поколение модел за изображения с по-висока качество на изхода, до 50% по-бързо генериране и обновено преживяване при редактиране. Той наследява ChatGPT Images 2 от April 2026 г. и незабавно се превръща в стандартния двигател за изображения в ChatGPT за всички потребители на всички нива.
Контекстът около това пускане е зашеметяващ: хората вече създават повече от 3 милиарда изображения всяка седмица чрез ChatGPT Images и GPT-Image моделите, достъпни в API. Images 2.5 се разгръща за всички потребители на ChatGPT, ChatGPT Work и Codex на настолни компютри, мобилни устройства и в уеб — заедно с два нови API модела, предназначени за различни производствени натоварвания.
What Is ChatGPT Images 2.5?
Пускане и позициониране
OpenAI пусна ChatGPT Images 2.5 на 8 септември 2026 г., представяйки го като най-мощния модел за изображения на компанията до момента. Той следва ChatGPT Images 2, който се появи в April 2026 г. — приблизително пет месеца по-рано, — и идва след пускането на GPT-6 Astra. Новият модел за изображения на OpenAI е проектиран да служи като текущ стандартен двигател за генериране в ChatGPT — което означава, че всяка нова заявка за изображение автоматично се изпълнява на Images 2.5 без никаква промяна в настройките.
Моделът заема върха на линия, която се простира до DALL-E — най-ранното изследване на изображения на OpenAI. През този период фокусът се е изместил от чисти изследователски демонстрации към инструменти от производствен клас: многоходово редактиране, вярност към референтните материали и скорост при мащаб имат значение повече от единствено новаторски показатели.
Кой може да го използва
Images 2.5 е достъпен за всички нива на ChatGPT — включително безплатното ниво, — както и за абонати на ChatGPT Work и Codex. Достъпът обхваща настолни приложения, мобилното приложение и уеб интерфейса. For разработчиците два нови API модела (GPT-Image-2.5 Flare и GPT-Image-2.5 Sunburst) бяха пуснати едновременно и са достъпни чрез стандартната крайна точка на OpenAI API.
Какво е ново в сравнение с ChatGPT Images 2
Скорост и качество
Основното подобрение е латентността: Images 2.5 постига до 50% по-ниска латентност при генериране на изображения в сравнение с предшественика си. Това означава забележимо по-бързи резултати при интерактивни сесии и значително по-висока пропускателна способност при API натоварвания. Освен скоростта, OpenAI съобщава за по-естествено осветление, по-богати текстури на повърхностите и по-точно визуализиране на реална информация, вградена в изображенията.
| Атрибут | ChatGPT Images 2 (April 2026) | ChatGPT Images 2.5 (September 2026) |
|---|---|---|
| Латентност при генериране | Базова | До 50% по-ниска |
| Осветление и текстури | Стандартни | По-естествени, по-богати |
| Редактиране в множество ходове | Добро | По-надеждно, натрупващо |
| Работа с фон | Ограничена | Пълна поддръжка на прозрачност |
| Последователност на стила | Умерена | По-последователна в отделните ходове |
| Точност на реален текст | Стандартна | Подобрена |
Предшественикът Images 2 въведе изходна резолюция 2K, множество съотношения на страните, интеграция с уеб търсене, поддръжка на не-латински писмености и две нива на интелигентност (Instant и Thinking). Images 2.5 надгражда всичко това, вместо да го замества.
Вярност към референциите и прецизно редактиране
Едно от най-практичните подобрения е начинът, по който моделът работи с референтни снимки. Images 2.5 запазва субектите от референтните изображения с по-висока вярност — лица, обекти и фирмени елементи се пресъздават по-точно, когато се използват като входни данни.
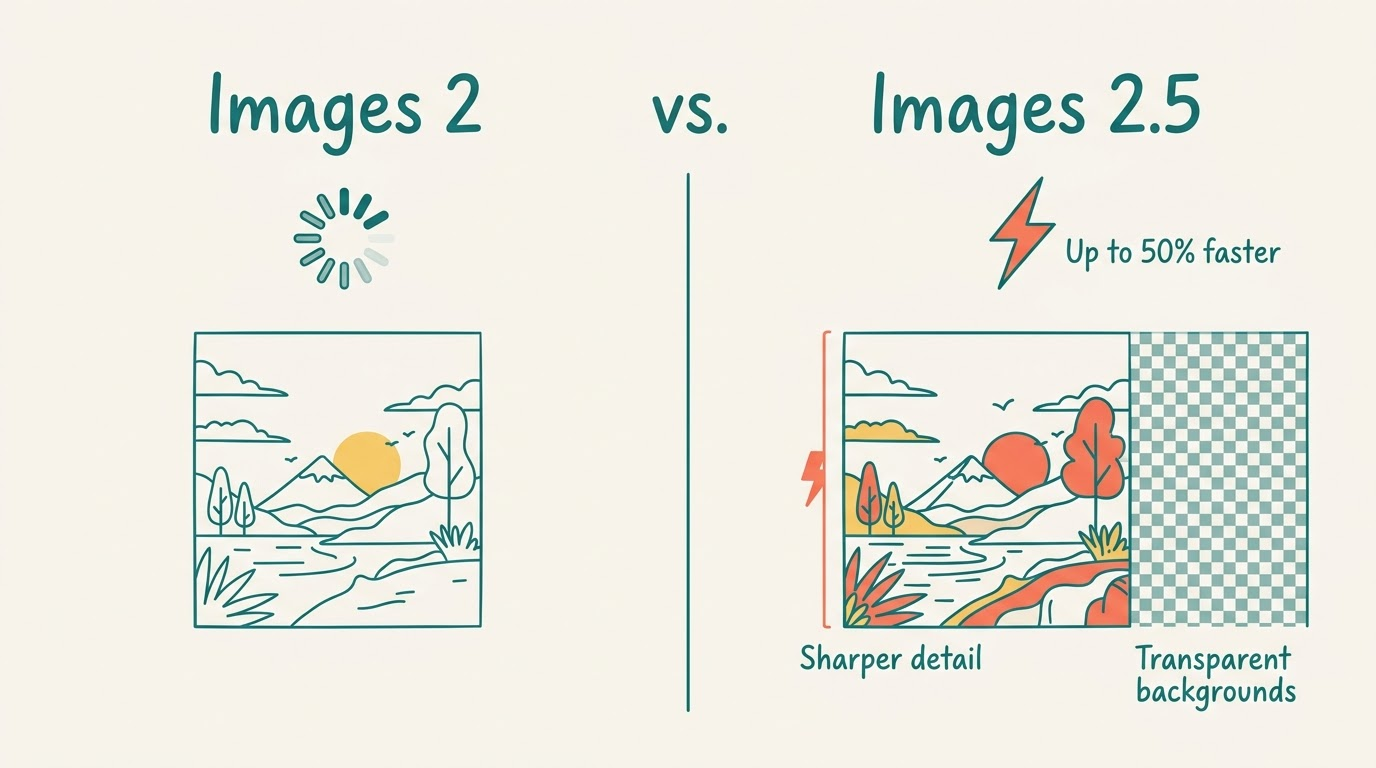
Прецизността на редактиране също се подобри значително. Моделът вече променя само изрично заявените елементи, оставяйки останалата част от изображението непокътната дори когато фонът или другите субекти са визуално сложни. Прозрачните фонове и сложните композитни оформления се обработват надеждно, което премахва честа точка на търкане при работни процеси за продукти и е-търговия.
В по-дълги разговори с множество ходове по-ранните редакции се запазват: всяка нова инструкция надгражда предишната работа, вместо да нулира визуалното състояние, и качеството не се влошава с нарастването на нишката. Заявените визуални стилове също се поддържат по-последователно от редакция на редакция.
Нови инструменти за създаване: Sketch, Templates, коментари и споделяне на подкани
Sketch
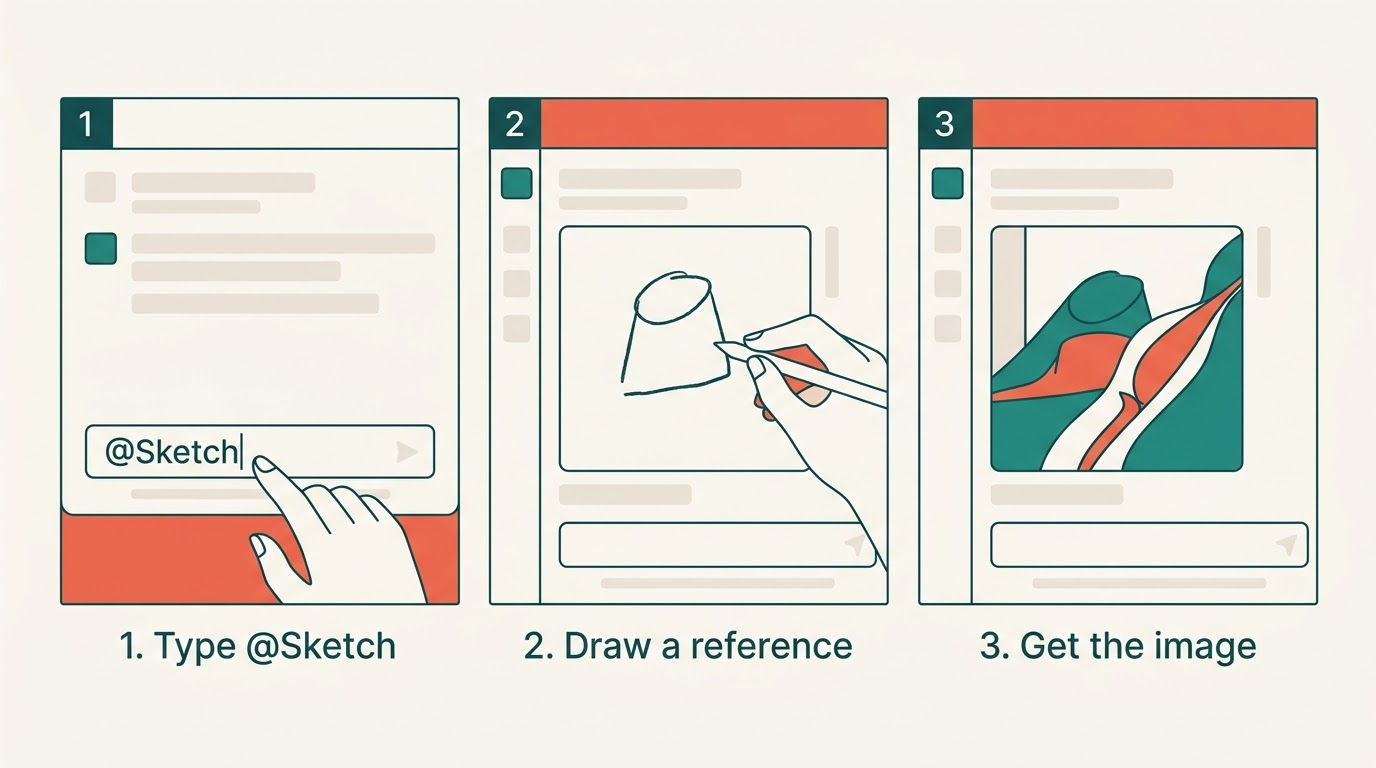
Най-отличителната нова функция на ChatGPT, включена с Images 2.5, е Sketch. Напишете „@Sketch” в произволен чат, за да отворите платно за рисуване директно в ChatGPT, където можете да скицирате груп визуална препратка — оформление, форма, пространствена връзка — която моделът използва като ориентир при генерирането на крайното изображение. Повърхността Sketch е достъпна в уеб и десктоп клиентите. Това запълва пропастта между словесните описания и визуалното намерение: вместо да описвате композиция с думи, вие я рисувате. За пълно ръководство вижте нашия наръчник за функцията за рисуване Sketch.
Templates, коментари и споделяне на подкани
Templates предоставят готови отправни точки за разпространени визуални формати. Сред наименованите опции са „Poster” за събития и маркетингови флаери и „Merch” за мокъпи на продукти — и двете покриват най-честите случаи на употреба, които преди са изисквали ръчно съставяне на подкани от нулата.
Коментарите вече могат да се поставят директно върху генерирано изображение, за да се посочи точно кой район или елемент се нуждае от корекция, което премахва необходимостта от дълги текстови описания на пространственото местоположение. Функцията работи подобно на анотацията в инструментите за дизайн: кликнете върху област и въведете инструкцията за редактиране.
Споделянето на подкани ви позволява да експортирате подканата зад всяко генерирано изображение, така че другите да могат да повторят същата идея, използвайки собствени снимки и контекстни подробности. Това е полезно за екипи, работещи итеративно върху визуален стил, и за създатели, които искат да изградят преизползваеми рецепти за изображения, вместо фиксирани резултати.
GPT-Image-2.5 Flare срещу Sunburst (API)
Заедно с актуализацията на ChatGPT бяха пуснати два отделни API модела: GPT-Image-2.5 Flare и GPT-Image-2.5 Sunburst. Те споделят една и съща основна архитектура за генериране, но са настроени за различни производствени контексти.
| Модел | Целеви случай на употреба | Латентност | Предимства |
|---|---|---|---|
| GPT-Image-2.5 Flare | Съдържание за създатели, социални мрежи, продуктов UX, бързо прототипиране, голям обем | 50% по-ниска от GPT-Image-2 | Скорост, прозрачни фонове, висока производителност |
| GPT-Image-2.5 Sunburst | Рекламни кампании, изчистени продуктови изображения, висококачествени визуални работни потоци | По-висока | По-прецизен контрол при редактиране, производствена последователност |
Flare — бързият вариант по подразбиране
GPT-Image-2.5 Flare е изборът по подразбиране в API за повечето приложения: генерира изображения с по-високо качество от GPT-Image-2 при 50% по-ниска латентност. Ранните оценки на екипа на Manus, воден от Lucky Liao, показват, че Flare работи два до четири пъти по-бързо от GPT-Image-2 с осезаемо подобрено генериране на прозрачен фон — показател от съществено значение за продуктова фотография и наслагвания в електронната търговия.
Flare е насочен към задачи, при които обемът и бързината имат значение:
- Конвейери за създаване на съдържание и публикации в социалните мрежи
- Миниатюри за продуктово изживяване и функции за визуално търсене
- Бързо прототипиране
- Сценарии с голям обем заявки към API, при които пропускателната способност е ограничаващ фактор
Sunburst — прецизност от висок клас
GPT-Image-2.5 Sunburst е създаден за визуални работни процеси от висок клас, изискващи по-стриктен контрол в поредица от редакции. Заявените силни страни са рекламни материали, готови за производство, и изчистени продуктови изображения. Времето за генериране е по-дълго от това на Flare, но компромисът се изразява в по-голяма последователност и прецизност, когато творческото задание го изисква.
Как да изберете между двата варианта на практика:
- Започнете с Flare при всеки нов проект — той се справя с огромното мнозинство от случаи на употреба.
- Оценете качеството на резултатите спрямо вашите визуални стандарти след 10–20 тестови генерации.
- Ако последователността на ниво рекламна кампания или прецизността при многоетапно редактиране не отговаря на изискванията, преминете към Sunburst.
- Проведете тест за латентност при конкретните за вас размери на изображенията и сложност на промпта.
- Вземете предвид разходите — и двата модела имат еднакво ценообразуване на токен, така че изборът е изцяло между качество и скорост.
- Следете процента отхвърлени резултати в производствена среда; по-ниският процент на нежелани генерации при Sunburst може да е от значение при съдържание, подложено на строга проверка.
Ценообразуване и наличност в API
Ценообразуване на токени
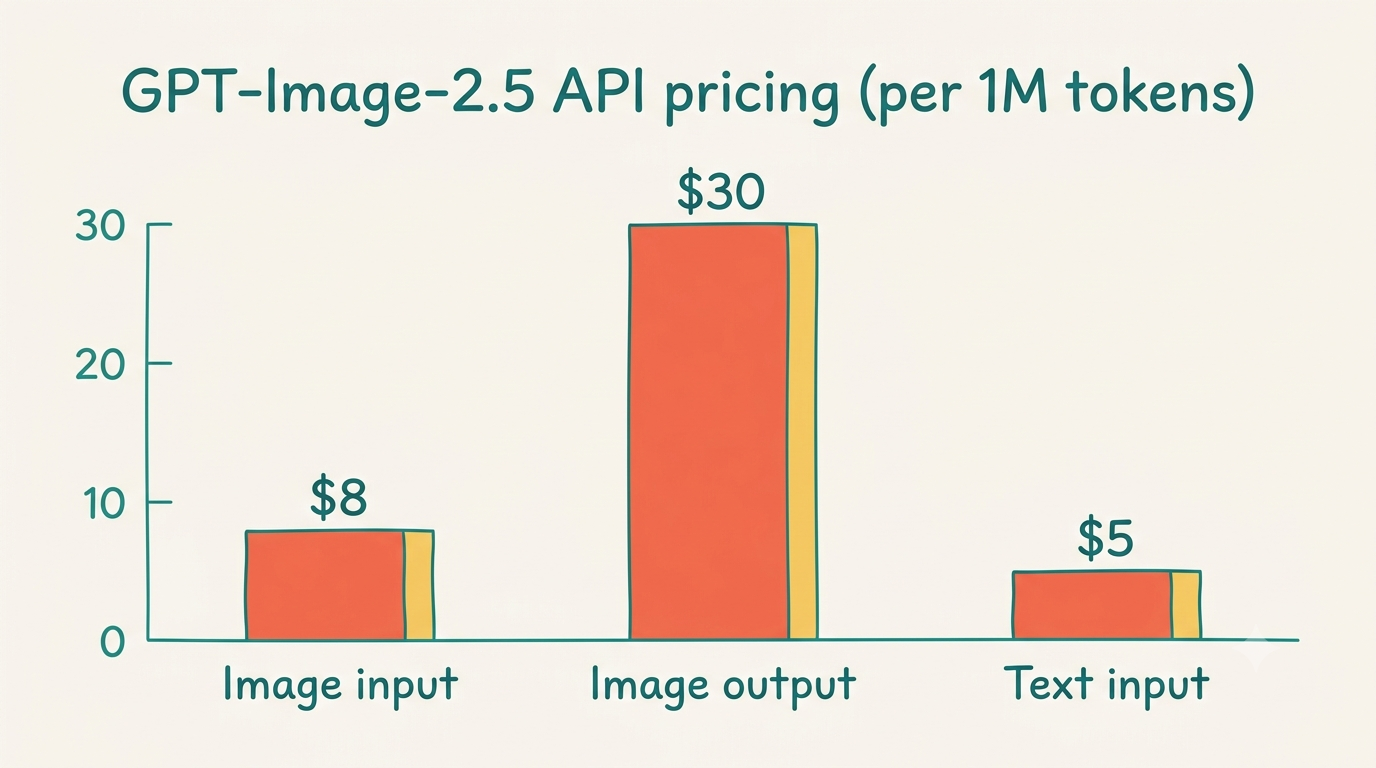
И двата модела GPT-Image-2.5 използват еднакви тарифи на страницата за цени на OpenAI:
- Входящи изображения: $8,00 на 1M токена ($2,00 при кеширане)
- Изходящи изображения: $30,00 на 1M токена
- Входящ текст: $5,00 на 1M токена ($1,25 при кеширане)
Структурата на ценообразуване следва същия модел, базиран на токени, който OpenAI използва при своите езикови API, което означава, че кешираните входни данни са значително по-евтини — от значение за всеки работен процес, при който едни и същи референтни изображения се обработват многократно.
Екосистема
GPT-Image-2.5 вече е интегриран в Adobe Firefly, инструментариума за генеративен дизайн, чрез партньорство, обявено заедно с пускането на модела. Мат Шотин от Adobe потвърди интеграцията. Higgsfield AI и Manus също бяха посочени като ранни партньори, изграждащи продукти върху новите API модели.
Правим най-мощния модел за генериране и редактиране на изображения достъпен за всички — от индивидуални творци до корпоративни екипи — защото визуалната интелигентност се превръща в толкова фундаментална, колкото и езиковата интелигентност.OpenAI, announcing ChatGPT Images 2.5
Безопасност, водни знаци и произход
Многопластова безопасност
Системна карта, публикувана на 8 септември 2026 г., описва архитектурата на безопасността зад Images 2.5. Подходът е многопластов: проверки на политиките, базирани на LLM, оценяват и отказват нарушаващи заявки преди да започне каквото и да е генериране, а отделен модел за безопасно разсъждение наблюдава както текстовите, така и графичните входни данни, като същевременно проверява всички изходни данни след генерирането.
OpenAI проведе автоматизирани состезателни оценки за измерване на дела на небезопасните изходни данни, заобиколили тези защити:
- Sunburst: 1,09% дял на небезопасно генериране при состезателни условия
- Flare: 1,41% дял на небезопасно генериране при состезателни условия
- базова линия Images 2.0: 1,64%
И двата нови модела отбелязват резултати под базовата линия на предшественика. Оценката по рамката Preparedness установи, че нито един от моделите не превишава праговете Bio High или Cyber High — двете най-чувствителни категории риск, които OpenAI проследява за граничните модели.
Произход: SynthID + C2PA
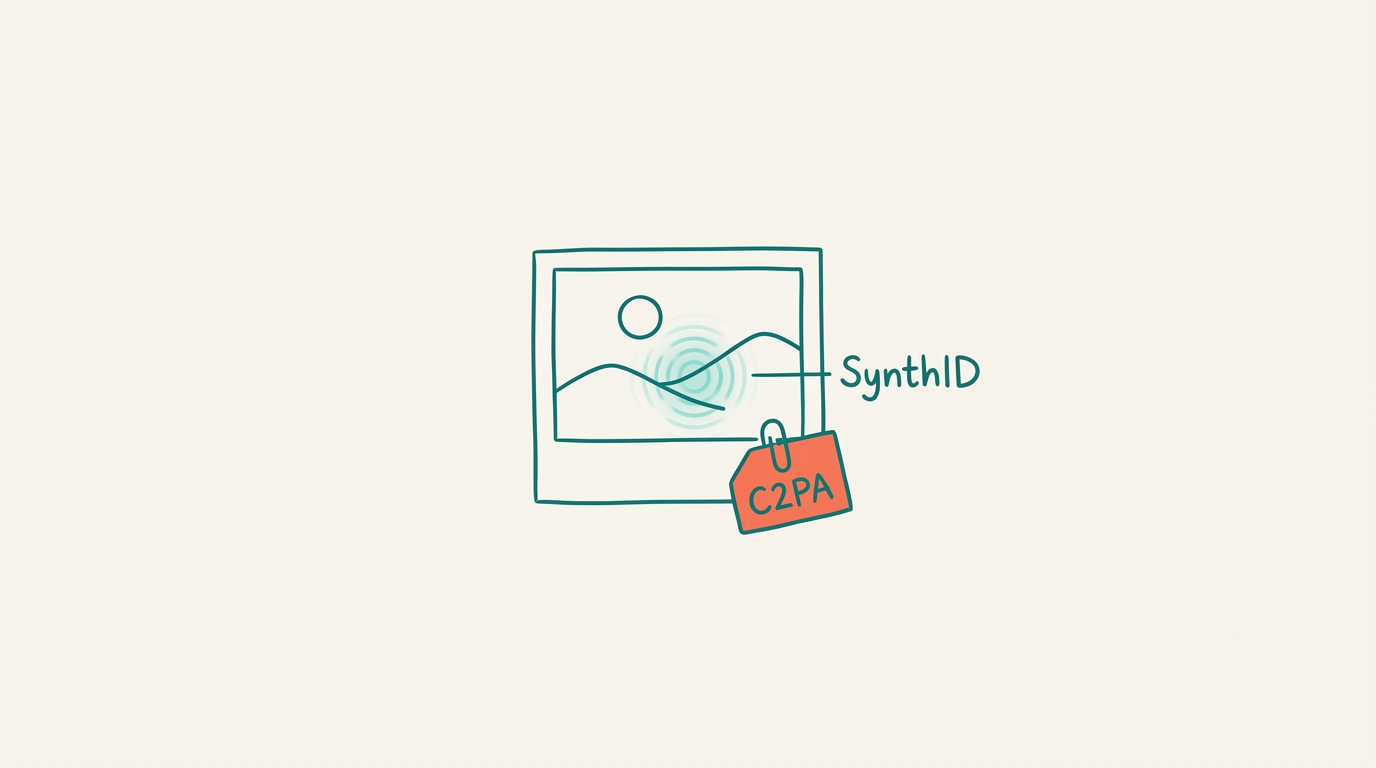
Всяко изображение, генерирано от Images 2.5, носи два пласта маркировка за произход. Първият е метаданните C2PA — машинночетим запис с информация за произхода, вграден съгласно стандарта C2PA Conformance Program, който позволява на инструменти, платформи и браузъри надолу по веригата да показват верифициран произход, без да модифицират видимото изображение.
Вторият пласт е SynthID — невидимата система за водни знаци на Google DeepMind. За разлика от видимите водни знаци, SynthID кодира неусетим сигнал в пикселната структура, който оцелява при обичайни трансформации като преоразмеряване или повторно JPEG компресиране. Според прегледа на SynthID в Wikipedia, технологията първоначално е разработена за изображения — стартирана за пръв път през август 2023 г. за снимки, генерирани от Imagen — и оттогава се е разширила до аудио, видео и текст.
И двата механизма за произход се прилагат в ChatGPT, Codex и OpenAI API — така всяка повърхност, която генерира изображение чрез Images 2.5, произвежда проследим резултат. За по-задълбочено обяснение прочетете нашия анализ на това как работи водният знак SynthID върху AI изображения.
FAQ
Кога беше пуснат ChatGPT Images 2.5?
ChatGPT Images 2.5 беше пуснат на 8 септември 2026 г. — приблизително пет месеца след ChatGPT Images 2, който излезе през април 2026 г.
Каква е разликата между GPT-Image-2.5 Flare и Sunburst?
Flare е стандартният API модел, оптимизиран за скорост — предлага по-високо качество от GPT-Image-2 при 50% по-ниска латентност, което го прави идеален за задачи с голям обем и в реално време. Sunburst е насочен към висококачествени визуални работни процеси с по-прецизен контрол при редактиране и последователност на продукционно ниво, но за сметка на по-дълго време за генериране.
Колко струва ChatGPT Images 2.5 в API?
Flare и Sunburst използват едни и същи тарифи: входни изображения $8.00 за 1M токена ($2.00 при кеширане), изходни изображения $30.00 за 1M токена, и текстов вход $5.00 за 1M токена ($1.25 при кеширане).
Как да използвам функцията Sketch в ChatGPT?
Напишете “@Sketch” в произволен чат в ChatGPT, за да отворите платното за рисуване. Скицирайте приблизително оформление или форма като визуална отправна точка, след което опишете желаното изображение — ChatGPT Images 2.5 използва вашата рисунка, за да насочи крайния резултат.
Изображенията от ChatGPT Images 2.5 имат ли воден знак?
Да. Всяко изображение съдържа C2PA метаданни (машинночитаем произход) и невидим воден знак SynthID на Google DeepMind. И двете се прилагат в ChatGPT, Codex и API.
ChatGPT Images 2.5 безплатен ли е?
Images 2.5 се предоставя на всички абонаментни нива на ChatGPT, включително безплатното, както и на ChatGPT Work и Codex. Използването на API с GPT-Image-2.5 Flare или Sunburst се таксува на токен според стандартните цени на OpenAI.