ChatGPT Images 2.5: Was ist neu am State-of-the-Art-Bildmodell von OpenAI
Am 8. September 2026 veröffentlichte OpenAI ChatGPT Images 2.5 — sein Bildmodell der nächsten Generation mit schärferen Ergebnissen, bis zu 50 % schnellerer Generierung und einer überarbeiteten Bearbeitungserfahrung. Es löst ChatGPT Images 2 vom April 2026 ab und wird sofort zur standardmäßigen Bild-Engine in ChatGPT für alle Nutzer auf jeder Stufe.
Der Kontext dieses Launches ist beeindruckend: Menschen erstellen bereits mehr als 3 Milliarden Images pro Woche über ChatGPT Images und die im API verfügbaren GPT-Image-Modelle. Images 2.5 wird für alle ChatGPT-, ChatGPT Work- und Codex-Nutzer auf Desktop, Mobilgerät und im Web ausgerollt — gemeinsam mit zwei neuen API-Modellen, die für unterschiedliche Produktions-Workloads konzipiert sind.
Was ist ChatGPT Images 2.5?
Veröffentlichung und Positionierung
OpenAI hat ChatGPT Images 2.5 am 8. September 2026 veröffentlicht und positioniert es als das bisher leistungsfähigste Bildmodell des Unternehmens. Es folgt auf ChatGPT Images 2, das im April 2026 etwa fünf Monate zuvor erschien, und kommt im Zuge des GPT-6 Astra-Launches auf den Markt. OpenAIs neues Bildmodell ist darauf ausgelegt, als aktuelle Standard-Generierungs-Engine in ChatGPT zu dienen — das bedeutet, dass jede neue Bildanfrage automatisch auf Images 2.5 ausgeführt wird, ohne dass eine Einstellung geändert werden muss.
Das Modell steht an der Spitze einer Entwicklungslinie, die bis zu DALL-E, OpenAIs frühester Bildforschung, zurückreicht. In diesem Zeitraum hat sich der Fokus von reinen Forschungsdemos hin zu produktionsreifen Tools verschoben: mehrstufige Bearbeitung, Referenztreue und Geschwindigkeit im großen Maßstab sind wichtiger als bloße Novitäts-Benchmarks.
Wer es nutzen kann
Images 2.5 steht allen ChatGPT-Stufen zur Verfügung — einschließlich der kostenlosen Stufe — sowie ChatGPT Work- und Codex-Abonnenten. Der Zugang umfasst Desktop-Apps, die mobile App und die Web-Oberfläche. Für Entwickler wurden gleichzeitig zwei neue API-Modelle (GPT-Image-2.5 Flare und GPT-Image-2.5 Sunburst) veröffentlicht, die über den standardmäßigen OpenAI API-Endpunkt zugänglich sind.
Was ist neu gegenüber ChatGPT Images 2
Geschwindigkeit und Qualität
Die wichtigste Verbesserung betrifft die Latenz: Images 2.5 erzielt bis zu 50 % niedrigere Bildgenerierungslatenz im Vergleich zum Vorgänger. Das bedeutet spürbar schnellere erste Ergebnisse in interaktiven Sitzungen und deutlich höheren Durchsatz bei API-Workloads. Neben der Geschwindigkeit meldet OpenAI natürlichere Lichtverhältnisse, reichhaltigere Oberflächentexturen und eine präzisere Darstellung von in Bilder eingebetteten realen Informationen.
| Attribut | ChatGPT Images 2 (April 2026) | ChatGPT Images 2.5 (September 2026) |
|---|---|---|
| Generierungslatenz | Ausgangswert | Bis zu 50 % niedriger |
| Beleuchtung und Textur | Standard | Natürlicher, reichhaltiger |
| Mehrstufige Bearbeitung | Gut | Zuverlässiger, aufbauend |
| Hintergrundverarbeitung | Eingeschränkt | Volle Unterstützung transparenter Hintergründe |
| Stilkonsistenz | Mäßig | Konsistenter über mehrere Schritte |
| Genauigkeit von Realtextdarstellungen | Standard | Verbessert |
Der Vorgänger Images 2 führte 2K-Auflösung, mehrere Seitenverhältnisse, Web-Recherche-Integration, Unterstützung nicht-lateinischer Schriften und zwei Intelligenzstufen (Instant und Thinking) ein. Images 2.5 baut auf all dem auf, anstatt es zu ersetzen.
Referenztreue und präzise Bearbeitung
Eine der praktisch bedeutsamsten Neuerungen ist die Art, wie das Modell mit Referenzfotos umgeht. Images 2.5 bewahrt die Motive in Ihren Referenzbildern mit höherer Treue – Gesichter, Objekte und Markenelemente werden als Eingaben deutlich genauer wiedergegeben.
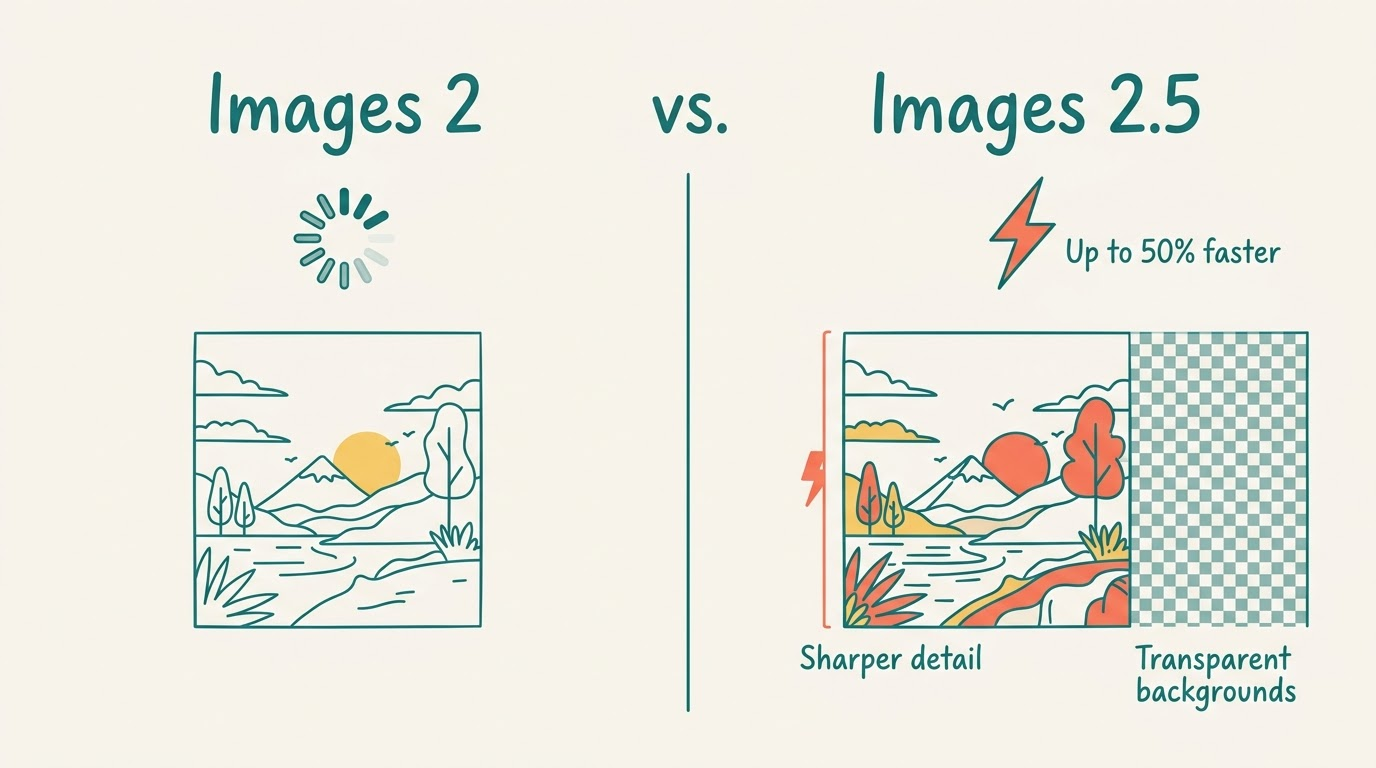
Auch die Bearbeitungspräzision hat sich deutlich verbessert. Das Modell ändert nun ausschließlich die Elemente, die Sie explizit anfordern, und lässt den Rest des Bildes unverändert – selbst wenn Hintergrund oder andere Motive visuell komplex sind. Transparente Hintergründe und komplexe Compositing-Layouts werden zuverlässig verarbeitet, was einen häufigen Reibungspunkt in Produkt- und E-Commerce-Workflows beseitigt.
In längeren mehrstufigen Konversationen bleiben frühere Bearbeitungen erhalten: Jede neue Anweisung baut auf der vorherigen Arbeit auf, anstatt den visuellen Zustand zurückzusetzen, und die Qualität verschlechtert sich auch bei länger werdenden Gesprächsverläufen nicht. Angeforderte visuelle Stile bleiben zudem von Bearbeitung zu Bearbeitung konsistenter.
Neue Erstellungswerkzeuge: Sketch, Templates, Kommentare und Prompt-Freigabe
Sketch
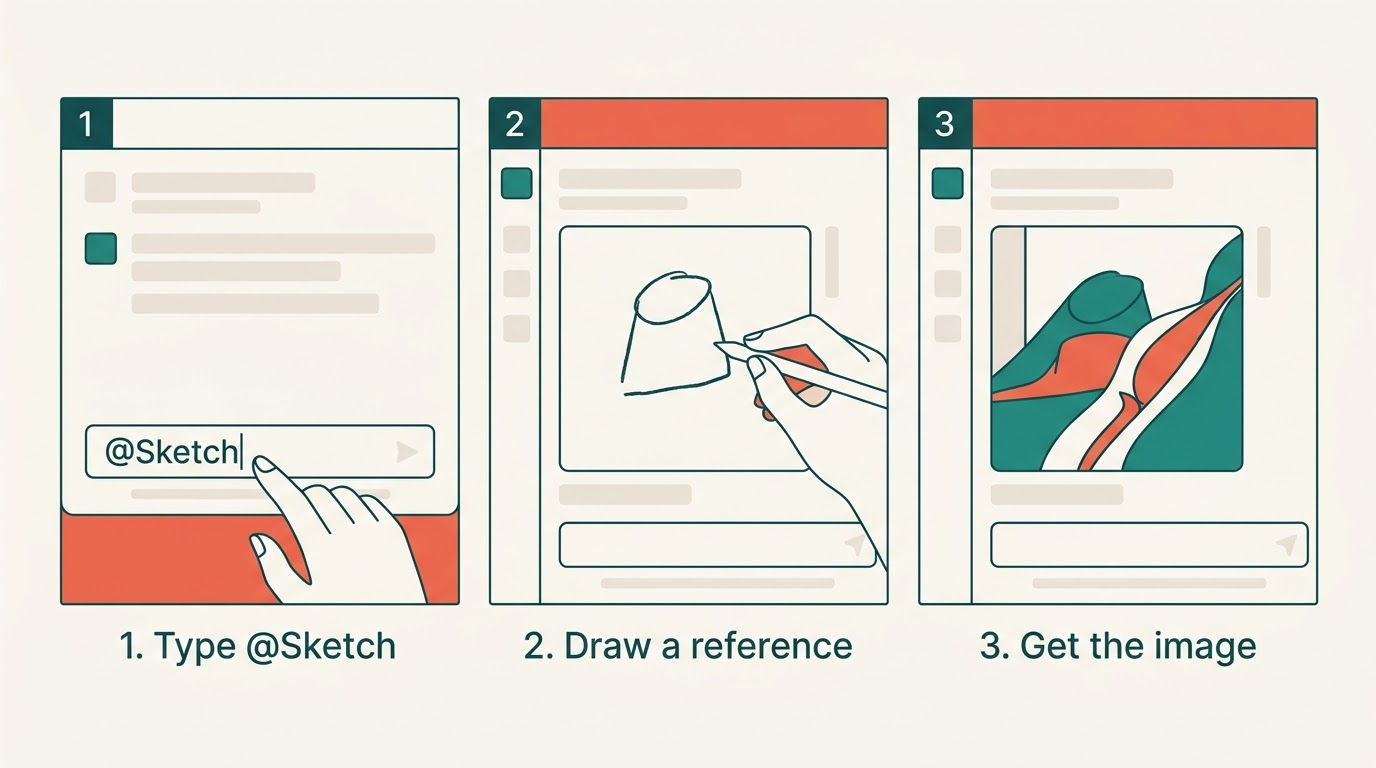
Das markanteste neue ChatGPT-Feature, das mit Images 2.5 eingeführt wird, ist Sketch. Gib „@Sketch” in einem beliebigen Chat ein, um eine Zeichenfläche direkt in ChatGPT zu öffnen. Dort kannst du eine grobe visuelle Referenz skizzieren – ein Layout, eine Form, eine räumliche Beziehung –, die das Modell als Vorlage für die Generierung des endgültigen Bildes verwendet. Die Sketch-Oberfläche ist im Web und in Desktop-Clients verfügbar. Das schließt die Lücke zwischen verbalen Beschreibungen und visueller Absicht: Statt eine Komposition in Worten zu beschreiben, zeichnest du sie einfach. Eine ausführliche Anleitung findest du in unserem Leitfaden zur Sketch-Zeichenfunktion.
Templates, Kommentare und Prompt-Freigabe
Templates bieten fertige Ausgangspunkte für gängige visuelle Formate. Zu den benannten Optionen gehören „Poster” für Veranstaltungs- und Marketing-Flyer sowie „Merch” für Produkt-Mockups – beides deckt die häufigsten Anwendungsfälle ab, für die bisher manuelles Prompting von Grund auf erforderlich war.
Kommentare können nun direkt auf einem generierten Bild platziert werden, um genau den Bereich oder das Element anzugeben, das angepasst werden soll – das ersetzt die Notwendigkeit, räumliche Positionen umständlich in Text zu beschreiben. Die Funktion funktioniert ähnlich wie Anmerkungen in Design-Tools: Klicke auf einen Bereich und gib die Bearbeitungsanweisung ein.
Mit der Prompt-Freigabe kannst du den Prompt hinter einem generierten Bild exportieren, damit andere dieselbe Idee mit ihren eigenen Fotos und kontextuellen Details erneut ausführen können. Das ist nützlich für Teams, die gemeinsam an einem visuellen Stil arbeiten, sowie für Creator, die wiederverwendbare Bildrezepte erstellen möchten, statt in sich geschlossene Ergebnisse zu liefern.
GPT-Image-2.5 Flare vs. Sunburst (API)
Zusammen mit dem ChatGPT-Update wurden zwei separate API-Modelle veröffentlicht: GPT-Image-2.5 Flare und GPT-Image-2.5 Sunburst. Sie teilen dieselbe zugrundeliegende Generierungsarchitektur, sind jedoch für unterschiedliche Produktionskontexte optimiert.
| Modell | Zielanwendungsfall | Latenz | Stärken |
|---|---|---|---|
| GPT-Image-2.5 Flare | Creator-Inhalte, Social Media, Produkt-UX, schnelles Prototyping, hohes Volumen | 50 % niedriger als GPT-Image-2 | Geschwindigkeit, transparente Hintergründe, hoher Durchsatz |
| GPT-Image-2.5 Sunburst | Kampagnen-Creatives, hochwertige Produktbilder, professionelle visuelle Workflows | Länger | Präzisere Bearbeitungskontrolle, konsistente Produktionsqualität |
Flare — der schnelle Standard
GPT-Image-2.5 Flare ist die Standard-API-Wahl für die meisten Anwendungen: Es liefert qualitativ hochwertigere Images als GPT-Image-2 bei 50 % geringerer Latenz. Erste Auswertungen des Manus-Teams unter der Leitung von Lucky Liao ergaben, dass Flare zwei- bis viermal so schnell wie GPT-Image-2 läuft und dabei eine spürbar verbesserte Generierung transparenter Hintergründe bietet — ein Merkmal, das für Produktfotografie und E-Commerce-Overlays von Bedeutung ist.
Flare richtet sich an Workloads, bei denen Volumen und Reaktionsschnelligkeit entscheidend sind:
- Creator- und Social-Content-Pipelines
- Produkt-Thumbnails und visuelle Suchfunktionen
- Schnelle Prototyping-Zyklen
- API-Szenarien mit hohem Durchsatz, bei denen der Datendurchsatz ein limitierender Faktor ist
Sunburst — Premium-Präzision
GPT-Image-2.5 Sunburst ist für professionelle visuelle Workflows konzipiert, die eine engere Kontrolle über eine Abfolge von Bearbeitungsschritten erfordern. Kampagnenmaterial in Produktionsqualität und hochwertige Produktbilder sind die ausgewiesenen Stärken. Die Generierungszeiten sind länger als bei Flare, doch der Kompromiss besteht in höherer Konsistenz und Präzision, wenn ein kreatives Briefing dies verlangt.
So wählen Sie in der Praxis zwischen beiden:
- Beginnen Sie jedes neue Projekt mit Flare — es bewältigt die große Mehrheit der Anwendungsfälle.
- Bewerten Sie die Ausgabequalität anhand Ihrer visuellen Anforderungen nach 10–20 Testgenerierungen.
- Falls Konsistenz auf Kampagnen-Niveau oder Präzision bei mehrstufiger Bearbeitung nicht ausreicht, wechseln Sie zu Sunburst.
- Führen Sie einen Latenz-Benchmark für Ihre spezifischen Bildabmessungen und die Komplexität Ihrer Prompts durch.
- Berücksichtigen Sie die Kosten bei der Entscheidung — beide Modelle haben identische tokenbasierte Preise, die Wahl ist daher reine Qualitäts- vs. Geschwindigkeitsfrage.
- Beobachten Sie die Ablehnungsraten in der Produktion; die niedrigere Rate adversarieller Generierungen bei Sunburst kann bei sicherheitskritischen Inhalten eine Rolle spielen.
Preise und Verfügbarkeit in der API
Token-Preise
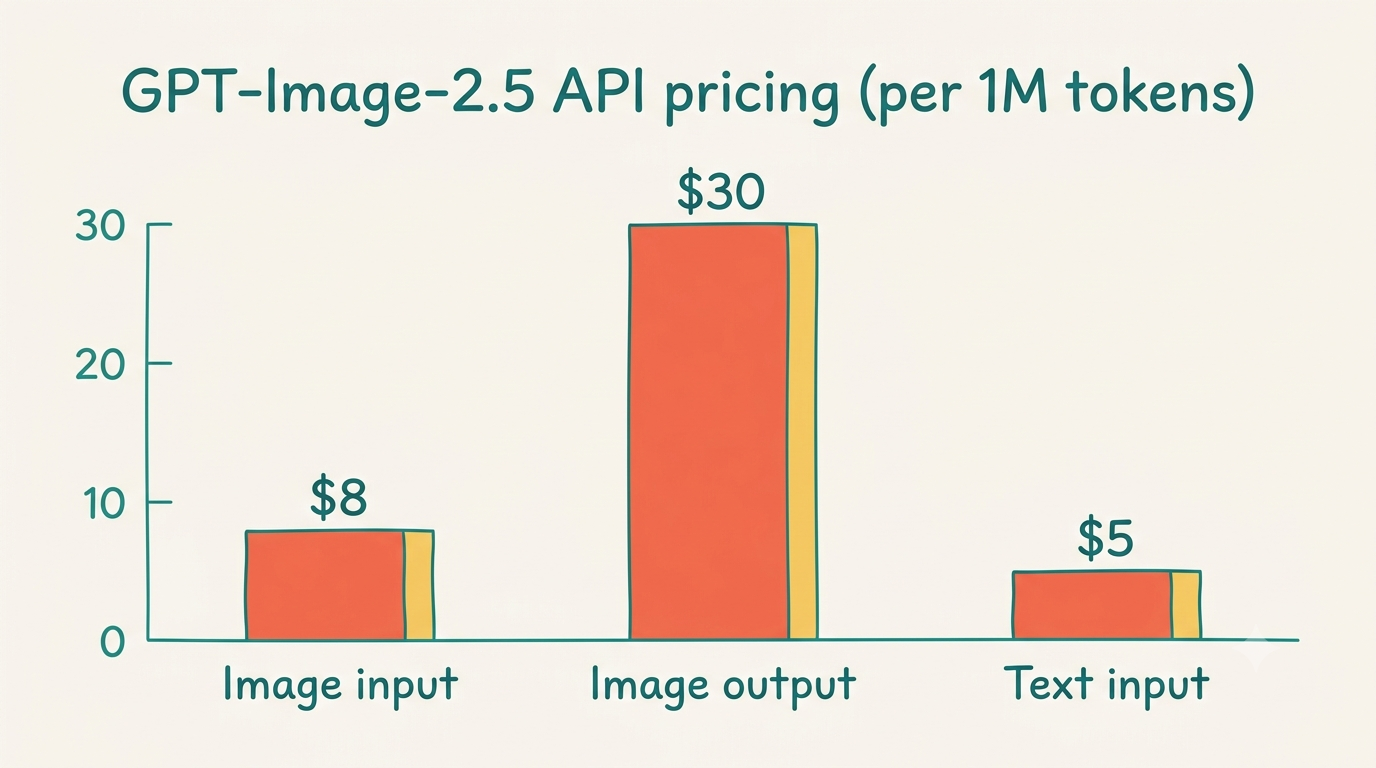
Beide GPT-Image-2.5-Modelle verwenden identische Tarife auf der OpenAI-Preisseite:
- Bild-Input: $8,00 pro 1 Mio. Tokens ($2,00 gecacht)
- Bild-Output: $30,00 pro 1 Mio. Tokens
- Text-Input: $5,00 pro 1 Mio. Tokens ($1,25 gecacht)
Die Preisstruktur folgt demselben tokenbasierten Modell, das OpenAI über seine Sprach-APIs hinweg verwendet. Das bedeutet, dass gecachte Eingaben deutlich günstiger sind — relevant für jeden Workflow, der ähnliche Referenzbilder wiederholt verarbeitet.
Ökosystem
GPT-Image-2.5 ist bereits in Adobe Firefly, das generative Design-Toolkit, integriert – durch eine Partnerschaft, die gemeinsam mit dem Launch angekündigt wurde. Matt Chotin von Adobe bestätigte die Integration. Higgsfield AI und Manus wurden ebenfalls als frühe Partner genannt, die auf den neuen API-Modellen aufbauen.
Wir machen das leistungsstärkste Modell zur Bildgenerierung und -bearbeitung für alle zugänglich – von einzelnen Kreativen bis hin zu Unternehmensteams –, weil visuelle Intelligenz ebenso grundlegend wird wie Sprachintelligenz.OpenAI, announcing ChatGPT Images 2.5
Sicherheit, Wasserzeichen und Herkunftsnachweis
Mehrschichtige Sicherheit
Eine System Card, veröffentlicht am 8. September 2026, beschreibt die Sicherheitsarchitektur hinter Images 2.5. Der Ansatz ist mehrschichtig: LLM-basierte Richtlinienprüfungen bewerten regelwidrige Anfragen und lehnen sie ab, bevor eine Generierung beginnt; ein separates Safety-Reasoning-Modell überwacht sowohl Text- als auch Bildeingaben und prüft zusätzlich alle Ausgaben nach der Generierung.
OpenAI führte automatisierte adversariale Evaluierungen durch, um die Rate unsicherer Ausgaben zu messen, die diese Schutzmaßnahmen umgangen haben:
- Sunburst: 1,09 % adversariale Rate unsicherer Generierungen
- Flare: 1,41 % adversariale Rate unsicherer Generierungen
- Images 2.0-Baseline: 1,64 %
Beide neuen Modelle liegen unter dem Wert des Vorgängers. Die Bewertung im Rahmen des Preparedness Framework ergab, dass keines der Modelle die Schwellenwerte „Bio High” oder „Cyber High” überschreitet – die zwei sensibelsten Risikokategorien, die OpenAI für Frontier-Modelle verfolgt.
Herkunftsnachweis: SynthID + C2PA
Jedes mit Images 2.5 generierte Bild trägt zwei Schichten von Herkunftsmarkierungen. Die erste ist C2PA-Metadaten – ein maschinenlesbarer Ursprungsnachweis, der gemäß dem C2PA Conformance Program-Standard eingebettet wird und es nachgelagerten Tools, Plattformen und Browsern ermöglicht, einen verifizierten Herkunftsnachweis anzuzeigen, ohne das sichtbare Bild zu verändern.
Die zweite Schicht ist SynthID, das unsichtbare Wasserzeichensystem von Google DeepMind. Anders als sichtbare Wasserzeichen kodiert SynthID ein nicht wahrnehmbares Signal in die Pixelstruktur, das gängige Transformationen wie Größenänderungen oder JPEG-Rekomprimierung übersteht. Laut dem SynthID-Artikel auf Wikipedia wurde die Technologie ursprünglich für Bilder entwickelt – erstmals im August 2023 für von Imagen generierte Fotos eingeführt – und wurde seitdem auf Audio, Video und Text ausgeweitet.
Beide Herkunftsmechanismen gelten für ChatGPT, Codex und die OpenAI API – so erzeugt jede Oberfläche, die über Images 2.5 ein Bild generiert, eine nachverfolgbare Ausgabe. For eine ausführlichere Erklärung lesen Sie unsere Aufschlüsselung darüber, wie das SynthID-Wasserzeichen bei KI-Bildern funktioniert.
FAQ
Wann wurde ChatGPT Images 2.5 veröffentlicht?
ChatGPT Images 2.5 wurde am 8. September 2026 veröffentlicht – etwa fünf Monate nach ChatGPT Images 2, das im April 2026 erschienen war.
Was ist der Unterschied zwischen GPT-Image-2.5 Flare und Sunburst?
Flare ist das standardmäßige API-Modell, das auf Geschwindigkeit optimiert ist – es liefert eine höhere Qualität als GPT-Image-2 bei 50 % geringerer Latenz und eignet sich daher ideal für Anwendungsfälle mit hohem Volumen und Echtzeitanforderungen. Sunburst richtet sich an professionelle Bild-Workflows mit präziserer Bearbeitungskontrolle und produktionsreifer Konsistenz, auf Kosten längerer Generierungszeiten.
Was kostet ChatGPT Images 2.5 in der API?
Sowohl Flare als auch Sunburst verwenden dieselben Preise: Bild-Eingabe $8,00 pro 1 Mio. Token ($2,00 gecacht), Bild-Ausgabe $30,00 pro 1 Mio. Token und Text-Eingabe $5,00 pro 1 Mio. Token ($1,25 gecacht).
Wie verwende ich die Sketch-Funktion in ChatGPT?
Gib “@Sketch” in einem beliebigen ChatGPT-Chat ein, um die Zeichenfläche zu öffnen. Skizziere ein grobes Layout oder eine Form als visuelle Referenz und beschreibe anschließend das gewünschte Bild – ChatGPT Images 2.5 nutzt deine Zeichnung, um das Endergebnis zu steuern.
Sind Bilder von ChatGPT Images 2.5 mit einem Wasserzeichen versehen?
Ja. Jedes Bild enthält C2PA-Metadaten (maschinenlesbare Herkunftsinformationen) sowie das unsichtbare SynthID-Wasserzeichen von Google DeepMind. Beides gilt für ChatGPT, Codex und die API.
Ist ChatGPT Images 2.5 kostenlos?
Images 2.5 wird für alle ChatGPT-Tarife eingeführt, einschließlich des kostenlosen Tarifs, sowie für ChatGPT Work und Codex. Die API-Nutzung mit GPT-Image-2.5 Flare oder Sunburst wird token-basiert nach den Standardpreisen von OpenAI abgerechnet.