Modello OpenAI Sol: GPT-5.6 Sol Spiegato — Benchmark, Prezzi e Guida all’API
GPT-5.6 Sol è il livello di punta della famiglia di modelli GPT-5.6 di OpenAI, progettato per i compiti professionali più esigenti — dagli agenti di coding a lungo orizzonte alla ricerca in cybersecurity e ai flussi di lavoro in biologia. Sviluppato da OpenAI e rilasciato pubblicamente il 9 luglio 2026 come parte della generazione chat gpt 5.6, ottiene l’88.8% sul principale benchmark agentivo Terminal-Bench 2.1 — e la configurazione Sol Ultra ad alto utilizzo computazionale porta quel risultato al 91.9%.
Cos’è il Modello OpenAI Sol?
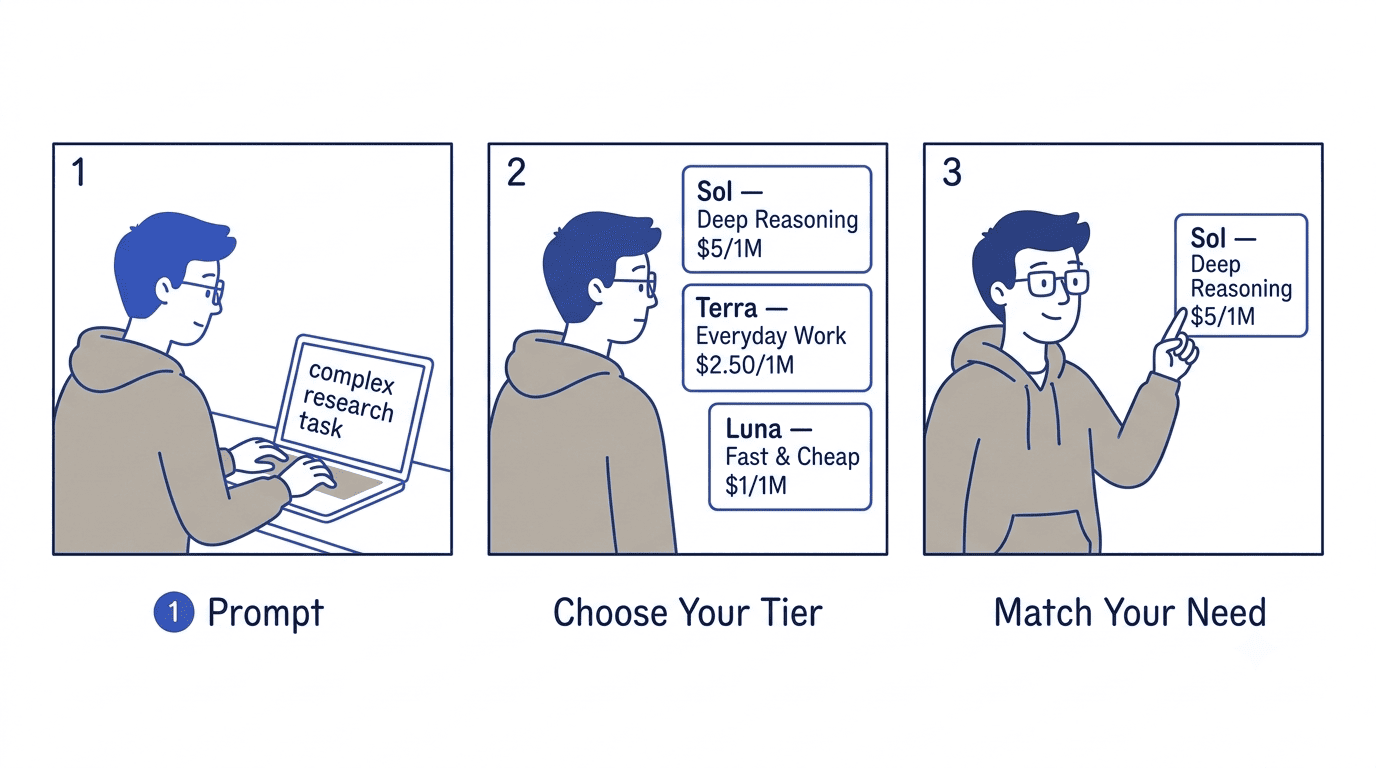
Sol è il modello frontier più capace di OpenAI per lavori professionali complessi. L’ID del modello API è gpt-5.6-sol, con l’alias gpt-5.6 che vi instrada automaticamente. La finestra di contesto è di 1.050.000 token con un output massimo di 128.000 token; il cutoff della conoscenza è il 16 febbraio 2026. Accetta input di testo e immagini e produce solo testo. OpenAI lo ha distribuito in due fasi — un’anteprima limitata il 26 giugno 2026 riservata a partner selezionati su richiesta della Casa Bianca per motivi di sicurezza, poi la disponibilità generale il 9 luglio dopo la conferma delle misure di protezione. OpenAI ha dichiarato che tali restrizioni di accesso “non dovrebbero diventare la norma”. La denominazione GPT-5.6 ha sostituito i suffissi precedenti (Turbo, Preview, Mini) con un sistema a tre livelli: il numero identifica la generazione, il suffisso il livello di capacità. Sol è il “sole” — il livello ad alta intensità, per lavori in cui la correttezza conta più del costo per token.
Sol vs Terra vs Luna: Quale Livello Scegliere
| Livello | Input (per 1M) | Output (per 1M) | Ideale per |
|---|---|---|---|
| GPT-5.6 Sol | $5.00 | $30.00 | Agenti complessi, coding, cybersecurity, biologia |
| GPT-5.6 Terra | $2.50 | $15.00 | Implementazione delimitata, revisione iniziale |
| GPT-5.6 Luna | $1.00 | $6.00 | Chatbot ad alto volume, classificazione, riassunti |
Sol a $5/$30 per 1M token offre la massima capacità allo stesso prezzo di GPT-5.5. Terra offre una qualità paragonabile a GPT-5.5 a circa metà del costo (vedi il confronto con GPT-5.6 Terra); Luna è il livello più veloce ed economico. La scelta del livello giusto dipende da cosa accade quando il modello fallisce: usa Sol per lavori multi-file e multi-step in cui la correttezza è critica; Terra per implementazioni delimitate e revisione iniziale; Luna per preprocessing ed etichettatura ad alto volume. Sol Ultra alloca più compute per richiesta — 91.9% contro 88.8% su Terminal-Bench 2.1 — allo stesso prezzo $5/$30 (più token, non una tariffa più alta), accessibile tramite reasoning.effort: "max" nell’API Responses.
Benchmark a Confronto con i Concorrenti
| Benchmark | GPT-5.6 Sol | Sol Ultra | GPT-5.5 | Claude Fable 5 |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 88.8% | 91.9% | 88.0% | 84.3% |
| DeepSWE v1.1 | 72.7% | — | 67.0% | 69.7% |
| AA Coding Agent v1.1 | 80.0 | — | 76.4 | — |
| BrowseComp | 90.4% | 92.2% | 84.4% | 84.3% |
| OSWorld 2.0 | 62.6% | — | 47.5% | 54.8% |
| Agents’ Last Exam | 52.7% | — | 46.9% | 40.5% |
| SWE-Bench Pro | 64.6% | — | — | 80.0% |
| AA Intelligence v4.1 | 58.9 | — | — | 59.9 |
Il profilo di Sol è discontinuo in modi che contano per il routing: domina nelle attività agentive e di uso del computer, ma è superato da Claude Fable 5 nel coding puro su repository. Nell’Artificial Analysis Coding Agent Index v1.1, Sol ha ottenuto 80/100 — 2.8 punti sopra Fable 5, un nuovo stato dell’arte a costo inferiore e velocità maggiore. OSWorld 2.0 (uso del computer) è il salto più sorprendente: Sol al 62.6% supera di 15.1 punti il 47.5% di GPT-5.5. Sol guida anche su BrowseComp per la ricerca web approfondita (90.4%, Ultra 92.2%) e su Agents’ Last Exam (52.7%). Il contraltare più evidente è SWE-Bench Pro, dove l’80.0% di Fable 5 supera il 64.6% di Sol di 15.4 punti — concentrato nel giudizio architetturale aperto e nella generazione di codice a freddo, non nella persistenza agentiva multi-step.
“Vogliamo che la famiglia GPT-5.6 offra agli sviluppatori un vocabolario stabile e duraturo per il routing — non un modello da configurare con cursori, ma un livello da scegliere in base alla profondità del compito.”OpenAI, Post di Lancio GPT-5.6, Luglio 2026
La conclusione pratica: testa sia Sol che Fable 5 su task reali di repository prima di scegliere — il divario di 15 punti su SWE-Bench Pro non si mantiene uniforme su codebase e linguaggi reali.
Prezzi API: Tariffario Completo
I prezzi seguono due regimi in base alla lunghezza del contesto. Superare i 272.000 token di input comporta il ricalcolo dell’intera richiesta alle tariffe long-context — non solo i token oltre la soglia — quindi va pianificato esplicitamente.
| Tipo di Tariffa | Input | Input Cached | Scrittura Cache | Output |
|---|---|---|---|---|
| Standard (≤272K) | $5.00/M | $0.50/M | $6.25/M | $30.00/M |
| Long Context (>272K) | $10.00/M | $1.00/M | $12.50/M | $45.00/M |
| Batch/Flex | $2.50/M | $0.25/M | $3.13/M | $15.00/M |
| Priority | $10.00/M | $1.00/M | $12.50/M | $60.00/M |
Una richiesta standard da 200K input / 20K output costa circa $1.60; una richiesta long-context da 500K / 50K costa $7.25, con le tariffe long-context applicate all’intera richiesta. Il prompt caching (minimo 30 minuti, breakpoint espliciti) riduce le letture dalla cache a $0.50/M — il 90% in meno rispetto all’input non cached — ma le scritture in cache costano $6.25/M (1.25× rispetto all’input non cached), quindi scrivere ripetutamente contesto che non viene mai riutilizzato aumenta i costi. Misura il tasso di cache hit direttamente, non solo se il caching è abilitato.
Come Accedere a GPT-5.6 Sol
Sol ha raggiunto la disponibilità generale il 9 luglio 2026 tramite l’API OpenAI e ChatGPT. Tramite API, usa l’ID modello gpt-5.6-sol (o l’alias gpt-5.6) su Chat Completions o l’API Responses; imposta il reasoning effort (medium, high, o max per Sol Ultra). Il prezzo Batch si applica a $2.50/$15 per 1M. In ChatGPT, Free e Go non hanno accesso a Sol; Plus offre reasoning Medium e High; Pro, Business ed Enterprise aggiungono Extra High e Pro. Sol alimenta anche il contesto ChatGPT Work su Plus e superiori — vedi la panoramica di ChatGPT Work.
Chiamate Programmatiche agli Strumenti e Persistenza nel Coding
Programmatic Tool Calling è la nuova capacità API più significativa di Sol: invece di chiamare uno strumento alla volta e reindirizzare ogni risultato attraverso il contesto, Sol scrive uno script di orchestrazione JavaScript in un runtime ospitato che coordina più chiamate agli strumenti in un unico round trip. Un cliente al lancio che eseguiva lo stesso agente sugli stessi strumenti ha consumato il 63.5% di token in meno — da ~150.000 token per domanda a meno di 55.000 — rendendo fattibili pipeline prima proibitive per costo. È la soluzione migliore per filtraggio, join, ranking e aggregazione su risultati strutturati degli strumenti; le chiamate dirette agli strumenti rimangono più chiare dove ogni risultato richiede una nuova interpretazione semantica. Sol aggiunge anche reasoning persistente tra i turni, breakpoint espliciti per la cache e una beta multi-agente con subagenti paralleli.
Il differenziatore operativo di Sol nel coding è la persistenza — portare a termine il passo 8 di un’attività in 10 passaggi dove la maggior parte dei modelli si ferma, eseguire la verifica e intercettare avvisi non correlati prima di consegnare anziché fermarsi al primo test happy-path superato. In un’esecuzione di 100 task su TypeScript, Go, Python, JavaScript e Rust, Sol ha raggiunto un tasso di superamento del 63.7% a ~20.968 token di output/task contro il 40.7% di Terra a 55.594 token/task. Nella revisione del codice ha superato il 69.7% dei casi azionabili ma ha generato più rumore (31.6% di precisione azionabile), quindi la revisione in produzione con Sol richiede uno strato di filtraggio.
Cybersecurity e Biologia
Per il system card di OpenAI, Sol assiste efficacemente nella modellazione delle minacce, nella revisione del codice, nel patching e nel blue teaming, ma non può eseguire cyberattacchi autonomi; OpenAI ha classificato sia Sol che Terra al di sotto della soglia “Cyber Critical”. I classificatori in tempo reale per uso improprio in campo cyber e biologico possono bloccare richieste vicine ai confini di capacità, incluso del lavoro legittimo — valida il comportamento di rifiuto prima di distribuire. Sol mostra guadagni significativi sui benchmark SecureBio di biologia rispetto a GPT-5.5 (punteggi esatti non pubblicati) ed è posizionato come assistente alla ricerca, non come strumento autonomo indipendente.
FAQ
Che cos’è il modello OpenAI Sol?
Il modello OpenAI Sol è GPT-5.6 Sol — il livello di punta, con le capacità più elevate, nella famiglia di modelli GPT-5.6 di OpenAI. È progettato per lavori professionali complessi, tra cui agenti di codifica a lungo orizzonte, cybersecurity, ricerca biologica, utilizzo del computer e flussi di lavoro agentici multi-strumento. Rilasciato pubblicamente il 9 luglio 2026; ID modello API: gpt-5.6-sol.
Quanto costa GPT-5.6 Sol?
Tariffe standard (fino a 272K token in ingresso): $5,00 per 1M di token in ingresso e $30,00 per 1M di token in uscita. Input in cache: $0,50/M. Scritture in cache: $6,25/M. Le richieste superiori a 272K token in ingresso attivano le tariffe per contesti lunghi ($10,00 input / $45,00 output per 1M) per l’intera richiesta, non solo per l’eccedenza.
Qual è la differenza tra Sol, Terra e Luna?
Sol è il livello di punta per i compiti più difficili dove la correttezza è fondamentale ($5/$30 per 1M di token). Terra è il livello bilanciato per l’uso quotidiano — con una qualità paragonabile a GPT-5.5 a $2,50/$15 per 1M di token. Luna è il livello più veloce ed economico a $1/$6, ideale per lavori ad alto volume e sensibili alla latenza come la classificazione e la sintesi.
Che cos’è la modalità Sol Ultra?
Sol Ultra è una configurazione ad alto consumo di calcolo e ad alto impegno di GPT-5.6 Sol che utilizza più risorse computazionali per richiesta. Su Terminal-Bench 2.1 ha ottenuto il 91,9% rispetto all’88,8% del Sol base. È accessibile tramite reasoning.effort: "max" nell’API Responses. Il prezzo è lo stesso del Sol base — Sol Ultra utilizza più token per richiesta, non una tariffa diversa.
Come si confronta GPT-5.6 Sol con Claude Fable 5?
Sol è in testa su Terminal-Bench 2.1, BrowseComp, OSWorld 2.0 e Agents’ Last Exam; Fable 5 è in testa su SWE-Bench Pro (80,0% vs 64,6%) e nella valutazione architettonica aperta. Testa entrambi sui tuoi effettivi compiti di repository prima di decidere.
GPT-5.6 Sol è disponibile tramite le API di OpenAI?
Sì. GPT-5.6 Sol ha raggiunto la disponibilità generale tramite API il 9 luglio 2026. Utilizza l’ID modello gpt-5.6-sol o l’alias gpt-5.6. Supportato tramite gli endpoint Chat Completions, Responses API, Batch, Realtime e Assistants.
Quali piani ChatGPT includono GPT-5.6 Sol?
Plus: opzioni di ragionamento Medium e High. Pro, Business ed Enterprise: opzioni Medium, High, Extra High e Pro. I piani Free e Go non hanno accesso a Sol. I diritti del piano e i limiti di utilizzo possono variare — consulta il Centro assistenza di OpenAI per i dettagli aggiornati sull’accesso.
GPT-5.6 Sol supporta il fine-tuning?
No. Il fine-tuning non è attualmente supportato su GPT-5.6 Sol. Sono invece supportati: streaming, function calling, output strutturati, ragionamento e l’intera suite di strumenti dell’API Responses.