Open Weight vs Open Source AI Models: qual è la vera differenza?
“Open source” è diventata l’etichetta predefinita per qualsiasi modello AI scaricabile, ma la maggior parte di essi è semplicemente open-weight. Un modello come il Kimi K3 di Moonshot è un esempio emblematico di rilascio open-weight: i pesi sono pubblici, ma la ricetta di addestramento no. Questa distinzione determina cosa si può ispezionare, riprodurre, modificare e distribuire legalmente, e la Open Source Initiative ha trascorso anni cercando di definire questa linea con precisione.
Cosa significa davvero “Open Weight”
Un modello open-weight pubblica i parametri addestrati come file scaricabili, di solito nel formato .safetensors. Chiunque può scaricarli da un repository e metterli al lavoro senza mai vedere come il modello è stato costruito.
Cosa ottieni
Una volta in possesso dei pesi, il modello funzionante è davvero tuo da eseguire. Strumenti come Ollama, llama.cpp, vLLM e SGLang esistono proprio per servire questi modelli a pesi scaricabili, senza bisogno dell’infrastruttura di addestramento nascosta che li ha generati.
In pratica, un rilascio open-weight ti permette di:
- Scaricare il modello ed eseguire inferenze localmente, offline
- Effettuarne il fine-tuning sul proprio dataset
- Quantizzarlo per adattarlo a un laptop o a una singola GPU
- Distribuirlo sul proprio hardware o su un cloud privato
- Modificarne il comportamento tramite adapter, LoRA o strumenti di prompt
Cosa rimane chiuso
Quello che non puoi fare è ricostruire il modello da zero, perché il codice di addestramento, la pipeline di filtraggio e il dataset stesso rimangono privati. I modelli più frequentemente citati come esempi open-weight seguono esattamente questo schema:
- Llama
- Mistral
- DeepSeek
- Qwen
- Gemma
La voce di Wikipedia sul modello linguistico Llama documenta come Meta abbia pubblicato i pesi per ogni generazione mantenendo chiusa la pipeline di addestramento.
Cosa significa davvero “Open Source AI”
L’open source AI va oltre un semplice file di pesi: richiede la ricetta completa. La Open Source Initiative ha pubblicato la versione 1.0 della Open Source AI Definition il 28 ottobre 2024, richiedendo quattro libertà: il diritto di utilizzare il sistema per qualsiasi scopo, di studiarne il funzionamento, di modificarlo e di condividerlo con altri, con o senza modifiche.
Rispettare queste libertà significa fornire la “forma preferita per apportare modifiche”, non solo i parametri finali. Ciò include le informazioni sui dati (cosa ha plasmato il set di addestramento e come), il codice di addestramento e di inferenza, il tokenizer e i dettagli dell’architettura, oltre ai parametri stessi. I large language model completi costruiti in questo modo sono rari, perché il requisito è ben al di sopra del semplice caricamento di un file di pesi su una piattaforma di hosting.
Confronto diretto: la vera differenza
Il modo più chiaro per vedere il divario è confrontare ciò che ciascuna categoria offre concretamente.
| Cosa ottieni | Modello open-weight | Open source AI |
|---|---|---|
| Parametri scaricabili | Sì | Sì |
| Configurazione del modello e tokenizer | Sì | Sì |
| Codice di inferenza / esempi | Di solito | Sì |
| Codice di addestramento | No | Sì |
| Informazioni sui dati di addestramento | No | Sì |
| Pipeline di filtraggio / elaborazione dati | No | Sì |
| Riproducibilità completa da zero | No | Sì |
| Diritti di modifica illimitati | Dipende dalla licenza | Sì |
I pesi aperti ti danno accesso: un modello funzionante che puoi eseguire, ottimizzare e distribuire. L’open source AI ti dà autonomia: la capacità di capire perché il modello si comporta in un certo modo e di riprodurre o verificare autonomamente quel processo. La maggior parte dei rilasci commercializzati come “open” si ferma alla prima riga.
Perché la maggior parte dei modelli “open source” è solo open-weight
I cicli di addestramento per un modello frontier costano regolarmente decine di milioni di dollari, e i dataset che li alimentano mescolano contenuti raccolti dal web, con licenza e proprietari che un laboratorio non può semplicemente ripubblicare senza esporsi a rischi legali. Questa combinazione — costi e provenienza dei dati — è il motivo per cui quasi ogni modello commercializzato come “open source”, inclusi Llama, DeepSeek, Qwen e Gemma, è tecnicamente solo open-weight.
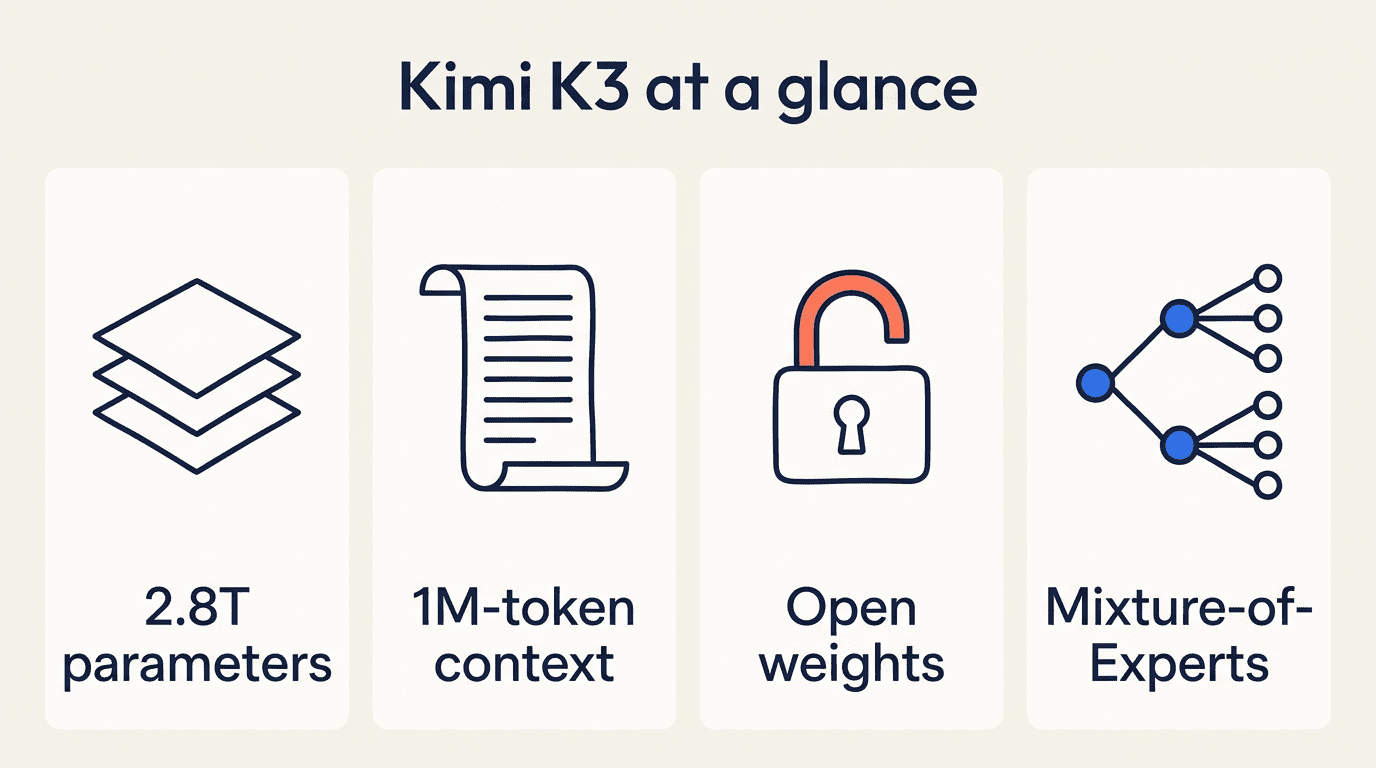
La piena trasparenza mette a rischio la posizione competitiva, non solo quella legale. Pubblicare l’esatta combinazione di dati e la pipeline di filtraggio significa consegnare ai concorrenti una ricetta che ha richiesto mesi di sperimentazione, quindi i laboratori rilasciano il risultato e tengono il processo per sé. Molti di questi flagship open-weight si affidano anche a un’architettura mixture-of-experts per contenere i costi di inferenza su larga scala, una scelta progettuale che vale la pena comprendere autonomamente prima di confrontare le famiglie di modelli. Moonshot AI, il laboratorio dietro Kimi K3, è una delle diverse aziende che ora distribuiscono modelli open-weight di scala flagship anziché modelli completamente open source, seguendo lo stesso schema dei propri pari.
Le FAQ della stessa Open Source Initiative sulla definizione spiegano perché un semplice file di pesi non sarebbe mai stato sufficiente:
La forma preferita per modificare un sistema AI comprende: il software utilizzato per creare il dataset, il software utilizzato per addestrare il sistema, i risultati dell’addestramento (ovvero i parametri) e tutti i dati legalmente condivisibili utilizzati nel processo di addestramento.Open Source Initiative
Cosa decide davvero la licenza
Scaricabile non significa illimitato. La licenza allegata ai pesi di un modello determina cosa si può fare legalmente con l’output, la ridistribuzione e il deployment commerciale — e varia molto di più di quanto l’etichetta “open” lasci intendere.
La MIT License e Apache 2.0 sono licenze permissive: impongono quasi nessuna restrizione sull’uso commerciale, la modifica o la ridistribuzione. Molti rilasci flagship vengono invece distribuiti con termini personalizzati o “community”, e la licenza Llama di Meta è il caso più emblematico: limita l’uso commerciale gratuito a 700 milioni di utenti attivi mensili e vieta esplicitamente una serie di casi d’uso specifici.
Questi termini personalizzati rientrano tipicamente in alcune categorie ricorrenti:
- Una soglia di scala (un limite di utenti o di fatturato oltre il quale è richiesto un accordo separato)
- Una restrizione sull’uso da parte di concorrenti (divieto di utilizzo in prodotti che competono con il fornitore)
- Un divieto di utilizzo dell’output del modello per addestrare modelli rivali
- Un requisito di branding (regole di denominazione o attribuzione per i prodotti derivati)
| Tipo di licenza | Uso commerciale | Ridistribuzione | Esempio |
|---|---|---|---|
| MIT / Apache 2.0 | Illimitato | Illimitata | Mistral (alcune versioni) |
| Licenza “community” personalizzata | Limitato per scala o caso d’uso | Consentita con condizioni | Llama |
| Pesi limitati / con accesso controllato | Richiede approvazione o accordo | Limitata o vietata | Alcune versioni solo per ricerca |
Questi termini personalizzati sono ciò che si intende con “pesi limitati” o modelli “source-available” — scaricabili, ma vincolati da una policy di utilizzo accettabile anziché da una licenza aperta standard.
Come verificare una model card in 30 secondi
Prima di dare per scontato che un rilascio sia open source, è sufficiente verificare quattro domande sulla sua model card.
- Posso scaricare ed eseguire i pesi sul mio hardware senza un’API a pagamento?
- Posso ispezionare come è stato addestrato il modello — il codice, non solo un articolo di blog riassuntivo?
- So quali dati hanno plasmato il modello, con abbastanza dettagli da comprenderne il comportamento?
- Posso modificare il modello e condividere la versione modificata senza chiedere il permesso?
Un “sì” alla sola prima domanda significa open-weight. Un “sì” a tutte e quattro è ciò che qualifica davvero un sistema come open source AI secondo la definizione dell’OSI, e pochi rilasci superano questo requisito oggi.
FAQ
Un modello open-weight è la stessa cosa dell’open source?
No. Open-weight significa che i parametri sono scaricabili alle condizioni indicate; l’IA open source richiede inoltre codice, informazioni sui dati e ampi diritti di modifica e ridistribuzione.
Llama è open source o open-weight?
Open-weight. I suoi pesi sono scaricabili, ma la licenza prevede restrizioni d’uso e i dati di addestramento completi nonché la pipeline non vengono rilasciati.
Cos’è la Open Source AI Definition?
Una specifica dell’Open Source Initiative (v1.0) che definisce l’IA open source attorno a quattro libertà fondamentali, più l’accesso alla forma preferita per apportare modifiche.
È possibile eseguire il fine-tuning di un modello open-weight?
Di solito sì: fine-tuning, adapter e quantizzazione sono le principali operazioni rese possibili dai pesi aperti, nel rispetto dei termini di licenza.
L’open source richiede la pubblicazione del dataset di addestramento grezzo?
No. La definizione OSI chiede informazioni sui dati sufficienti a comprendere e ricostruire un sistema equivalente, non necessariamente ogni singolo esempio grezzo.