GLM-5.2: il modello open-weight per il coding di Z.ai con contesto da 1M di token spiegato
GLM-5.2 è il modello linguistico open-weight di punta della piattaforma chatbot z.ai (già Zhipu AI), rilasciato a giugno 2026 con una finestra di contesto da 1 milione di token e licenza MIT — rendendolo il più potente LLM solo testo liberamente disponibile al momento del lancio. È costruito su un’architettura Mixture-of-Experts da 753 miliardi di parametri, ottiene il 62,1% su SWE-bench Pro e costa circa un sesto di GPT-5.5 in termini di costo API. Z.ai, un’azienda di ricerca con sede a Pechino nata come spin-off della Tsinghua University nel 2019, posiziona GLM-5.2 come modello di coding di livello frontier pronto per flussi di lavoro agentici e compiti di ragionamento a lungo orizzonte.
Cos’è GLM-5.2?
Da Zhipu AI a Z.ai: l’azienda dietro il modello
Zhipu AI si è rinominata Z.ai nel 2025 come parte della sua espansione globale. Fondata nel 2019 come spin-off della Tsinghua University, l’azienda pubblica la serie General Language Model (GLM) ininterrottamente fin da GLM-1. GLM-5.2 è la quinta generazione e la loro release frontier attuale. L’organizzazione THUDM su GitHub mantiene tutti i repository ufficiali e il codice di riferimento accademico per la famiglia di modelli.
GLM-5.2 in sintesi
GLM-5.2 è un modello sparse Mixture-of-Experts con 753 miliardi di parametri totali e circa 40 miliardi attivi per token. È stato rilasciato sotto licenza MIT senza restrizioni regionali. Il modello pesa 1,51 TB ed è diventato disponibile per gli abbonati al GLM Coding Plan il 13 giugno 2026, con i pesi open disponibili pubblicamente dal 16 giugno 2026.
Dati chiave in sintesi:
- 753 miliardi di parametri totali, ~40 miliardi attivi per token di inferenza
- Finestra di contesto da 1 milione di token (attivabile con
glm-5.2[1m]) - Licenza MIT — uso commerciale consentito, senza esclusioni regionali
- Punteggio del 62,1% su SWE-bench Pro, 74,4% su FrontierSWE
- Prezzo API: $1,40/1M token in input tramite Z.ai
Architettura: cosa rende diverso GLM-5.2
Design MoE: 753 miliardi di parametri, 40 miliardi attivi
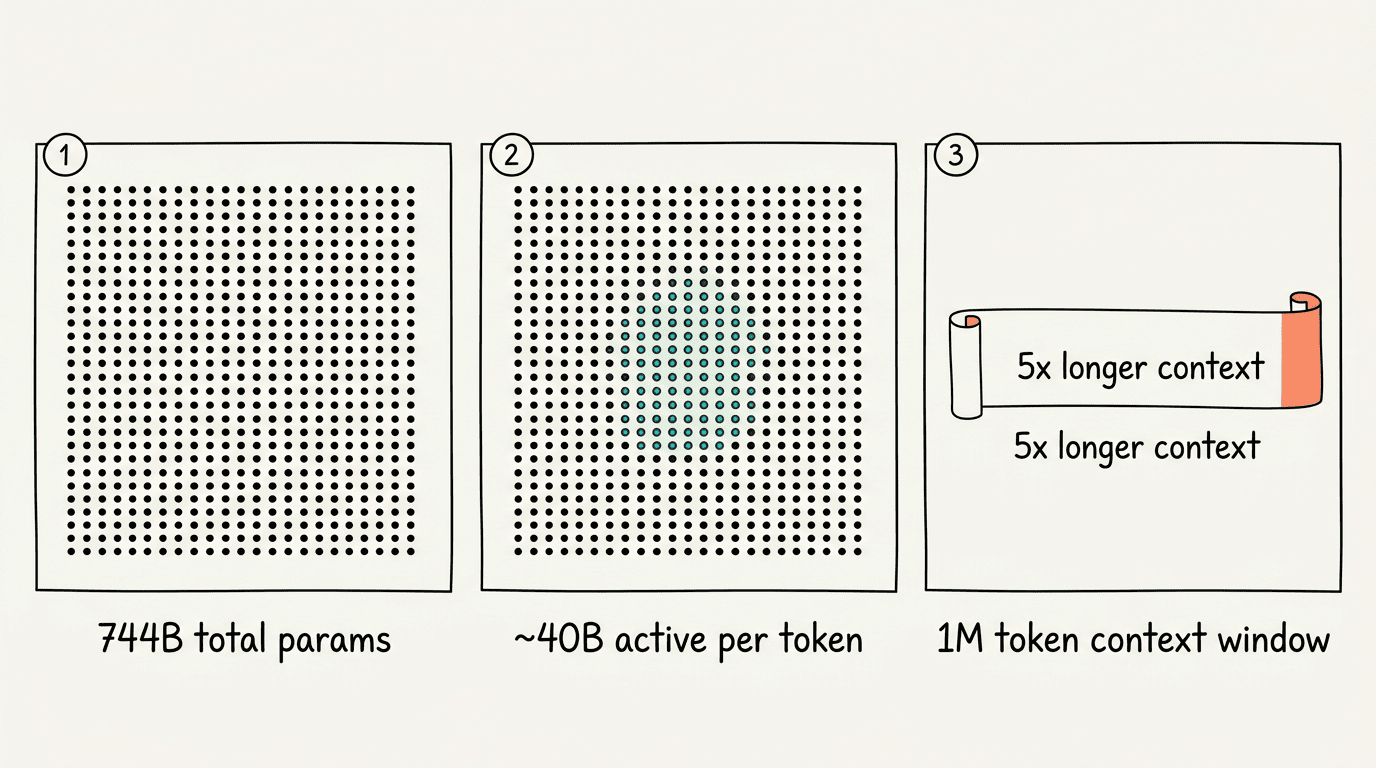
GLM-5.2 utilizza un design sparse Mixture-of-Experts (MoE): il modello completo contiene 753 miliardi di parametri, ma ogni singolo token in inferenza ne attiva solo circa 40 miliardi. Questo conferisce al modello open-weight da 753 miliardi di parametri la densità di conoscenza di un sistema molto grande al costo di inferenza di uno molto più piccolo. In pratica, è questo compromesso a rendere sostenibile un prezzo di $1,40/1M token in input per un modello che compete a livello frontier.
IndexShare: risolvere il problema del contesto da 1M
L’innovazione architettonica chiave è IndexShare, un meccanismo di sparse-attention che riutilizza lo stesso sparse indexer ogni quattro layer del transformer. Alla scala da 1M di token, IndexShare offre una riduzione del 2,9× nei FLOPs per token rispetto all’attenzione piena standard. Z.ai lo indica come la ragione principale per cui l’inferenza con contesto da 1M di token è economicamente sostenibile agli attuali prezzi — senza di esso, i requisiti di memoria e calcolo renderebbero la finestra di contesto commercialmente impraticabile.
Multi-Token Prediction e tecniche di supporto
GLM-5.2 include layer Multi-Token Prediction (MTP) migliorati abbinati a KVShare, che offrono fino al 20% di incremento nei tassi di accettazione dello speculative decoding. LayerSplit gestisce la memoria tra gli esperti MoE, e il PPO basato su Critic è stato utilizzato per il fine-tuning tramite reinforcement learning. Insieme, queste tecniche rendono il modello di coding agentico significativamente più veloce nella generazione rispetto al predecessore GLM-5.1 — l’output medio per task è cresciuto da ~26K token a ~43K token.
Le quattro principali tecniche architetturali in GLM-5.2:
- IndexShare — sparse indexer condiviso ogni 4 layer del transformer (riduzione 2,9× dei FLOPs con contesto da 1M)
- KVShare + MTP — condivisione del KV-cache combinata con Multi-Token Prediction per uno speculative decoding del 20% più veloce
- LayerSplit — gestione distribuita della memoria tra i layer degli esperti MoE
- PPO basato su Critic — fine-tuning tramite reinforcement learning per un migliore allineamento del ragionamento
Il meccanismo IndexShare ci consente di eseguire inferenza con 1M di token a un costo realmente competitivo con i modelli proprietari con contesto da 128K — questa è la scommessa architettonica su cui è costruito GLM-5.2.THUDM / Z.ai Engineering Team, GitHub
Finestra di contesto: 1 milione di token nella pratica
La finestra di contesto da 1 milione di token di GLM-5.2 è 5 volte più grande del limite di ~200K di GLM-5.1. In pratica, questo significa che il modello linguistico a lungo contesto può elaborare circa 750.000 parole contemporaneamente — un’intera codebase, un contratto legale corposo o un anno di log applicativi in un unico prompt.
L’accesso al contesto completo è opzionale tramite l’ID modello glm-5.2[1m]. Il modello produce fino a 131.072 token per risposta, e al livello di effort Max può generare fino a 85K token di output per task. L’output medio per i tipici task di coding è cresciuto a ~43K token, rispetto ai ~26K di GLM-5.1.
Il contesto esteso è ciò che rende possibili i casi d’uso di coding autonomo che Z.ai descrive come task a “lungo orizzonte” — consulta la panoramica del GLM Coding Plan per vedere come questi flussi di lavoro multi-step sono strutturati nella pratica.
Benchmark: come si confronta GLM-5.2
Benchmark di coding
Sui principali benchmark di coding al lancio:
| Benchmark | GLM-5.2 | GPT-5.5 | Claude Opus 4.8 | Gemini 3.1 Pro |
|---|---|---|---|---|
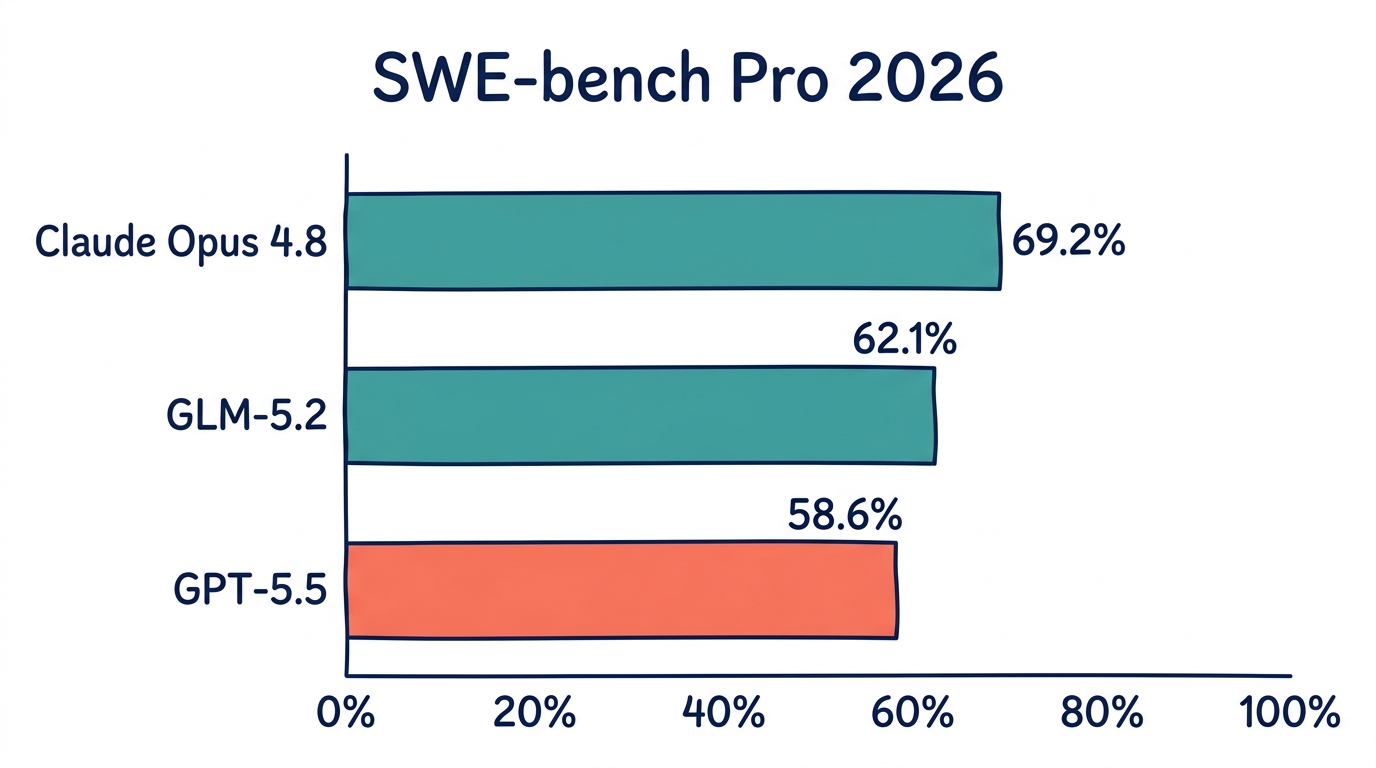
| SWE-bench Pro | 62,1% | 58,6% | — | 54,2% |
| FrontierSWE | 74,4% | 72,6% | 75,1% | — |
| Terminal-Bench 2.1 | 81,0 | — | 85,0 | — |
GLM-5.2 supera GPT-5.5 su SWE-bench Pro di 3,5 punti percentuali e si avvicina a Claude Opus 4.8 di meno dell’1% su FrontierSWE. Occupa inoltre il 2° posto nella classifica Code Arena: Frontend. Sull’Artificial Analysis Intelligence Index v4.1, l’ultimo LLM flagship di Z.ai ottiene 51 — davanti a MiniMax-M3 (44), DeepSeek V4 Pro (44) e Kimi K2.6 (43).
Matematica e ragionamento
Su AIME 2026 (competizione di matematica avanzata), GLM-5.2 ottiene il 99,2% — tra i punteggi più alti mai registrati per un modello open-weight e competitivo con i migliori sistemi proprietari. Questo lo posiziona come una scelta seria per flussi di lavoro di ragionamento quantitativo al di là del puro coding.
Test reale di cybersecurity
Il team di ingegneria di Semgrep ha testato GLM-5.2 su task di rilevamento di vulnerabilità IDOR, misurando sia l’accuratezza che il costo. Il modello di coding di livello frontier ha ottenuto un F1 score del 39% — superando Claude Code (Opus 4.6 al 37%, con Opus 4.8/4.7 al 28%) a circa $0,17 per vulnerabilità rilevata. Questo corrisponde a circa un sesto del costo dei sistemi proprietari frontier comparabili, rafforzando la proposta di valore che Z.ai promuove in termini di efficienza di prezzo.
Principali risultati benchmark in sintesi:
- SWE-bench Pro: 62,1% (contro il 58,6% di GPT-5.5)
- FrontierSWE: 74,4% (contro il 75,1% di Claude Opus 4.8)
- Terminal-Bench 2.1: 81,0
- AIME 2026 matematica: 99,2%
- Artificial Analysis Intelligence Index v4.1: 51 (punteggio più alto tra i modelli open-weight)
Modalità di ragionamento: effort High vs Max
GLM-5.2 dispone di due livelli di effort del ragionamento configurabili. La distinzione è rilevante nella pratica sia per il costo che per la qualità dell’output:
Effort High produce risposte più rapide con una profondità di chain-of-thought moderata. È adatto per task di coding standard, la maggior parte dei loop agentici e applicazioni sensibili alla latenza.
Effort Max attiva il pensiero esteso con fino a 85K token di output per task. Z.ai raccomanda esplicitamente Max per coding complesso su più file, flussi di lavoro agentici a lungo orizzonte e task che richiedono catene di ragionamento approfondite. Il modello è stato principalmente addestrato e valutato al livello di effort Max, il che si riflette nei numeri dei benchmark sopra riportati.
Per la maggior parte degli utenti che utilizzano il sistema orientato agli agenti come backend di coding, l’effort Max è il punto di partenza predefinito. L’effort High è una leva di riduzione dei costi una volta che un flusso di lavoro è dimostrato affidabile.
Prezzi e disponibilità
Prezzi API
L’API ufficiale di Z.ai applica $1,40 per milione di token in input, $4,40 per milione di token in output e $0,26 per input in cache. Su OpenRouter, gli host di terze parti offrono tipicamente tariffe leggermente inferiori, intorno a $0,95 in input / $3,00 in output.
Per fare un confronto, GPT-5.5 costa circa 6 volte di più su task equivalenti. L’implicazione pratica: il costo di cybersecurity di GLM-5.2 pari a $0,17 per vulnerabilità rilevata, contro circa $1,00 per i modelli frontier comparabili, illustra come il divario di prezzo si amplifichi nei flussi di lavoro automatizzati ad alto volume.
| Livello | Mensile | Annuale (al mese) | Quota |
|---|---|---|---|
| Lite | $18 | $12,60 | ~80 prompt / ~400 fuori picco |
| Pro | $72 | $50,40 | ~400 / ~2.000 |
| Max | $160 | $112,00 | ~1.600 / ~8.000 |
Le ore di picco (14:00–18:00 UTC+8) costano 3× quota; fuori picco 2×. Una tariffa promozionale 1× è attiva fino a settembre 2026.
Pesi open e HuggingFace
I pesi di GLM-5.2 sono pubblicati su Hugging Face nell’organizzazione THUDM e tramite zai-org/GLM-5.2. Una variante quantizzata (THUDM/GLM-Z1-9B-0414) è disponibile per ambienti con risorse limitate. La licenza MIT consente il self-hosting, il fine-tuning e l’implementazione commerciale senza restrizioni regionali. Il modello è conforme a SOC 2 e GDPR quando utilizzato tramite l’API di Z.ai.
Come utilizzare GLM-5.2: guida all’integrazione
Z.ai espone GLM-5.2 tramite un endpoint compatibile con Anthropic, il che significa che si inserisce in qualsiasi strumento già configurato per Claude con modifiche minime. Ecco una guida passo dopo passo per gli ambienti più comuni:
- Crea un account Z.ai su api.z.ai e genera una chiave API dalla dashboard.
- Imposta le variabili d’ambiente:
ANTHROPIC_BASE_URL=https://api.z.ai/v1eANTHROPIC_API_KEY=<your-z.ai-key>. - Seleziona l’ID modello: usa
glm-5.2per il contesto standard oglm-5.2[1m]per il contesto da 1M di token. - Imposta l’effort del ragionamento: passa
--effort maxper task di coding complessi;--effort highper esecuzioni più rapide ed economiche. - Verifica la connessione: esegui un semplice prompt di test per confermare che l’endpoint si risolva correttamente prima di impegnarsi in un flusso di lavoro in produzione.
- Tieni presente la quota: se utilizzi un abbonamento al Coding Plan, nota che le ore di picco (14:00–18:00 UTC+8) costano 3× la tua quota prompt.
- Abilita MCP se necessario: GLM-5.2 supporta nativamente il Model Context Protocol per le chiamate agli strumenti — aggiungi la configurazione del server MCP nello stesso modo in cui lo faresti per un’integrazione Claude standard.
Per Claude Code in particolare: imposta ANTHROPIC_BASE_URL e passa --model glm-5.2 (o glm-5.2[1m]) per sessione. Non sono necessarie altre modifiche alla configurazione.
Per Cline e gli strumenti compatibili con OpenAI (Roo Code, OpenClaw), punta il base URL su https://api.z.ai/v1, imposta la tua chiave API e seleziona glm-5.2 dall’elenco dei modelli. Per i flussi di lavoro di automazione, il framework agente AutoGLM è costruito attorno alle chiamate agli strumenti native di GLM-5.2 e all’integrazione MCP.
GLM-5.2 vs GLM-5.1: cosa è cambiato
Il salto da GLM-5.1 a GLM-5.2 è più di un aggiornamento incrementale — comporta un cambio architetturale completo da denso a sparse MoE, un’espansione del contesto 5×, e guadagni significativi su ogni principale benchmark di coding.
| Metrica | GLM-5.1 | GLM-5.2 |
|---|---|---|
| Finestra di contesto | 200K token | 1M token |
| SWE-bench Pro | 58,4% | 62,1% |
| Terminal-Bench 2.1 | 62,0 | 81,0 |
| Output medio per task | ~26K token | ~43K token |
| Architettura | Densa | Sparse MoE |
Il contesto da 1M è l’aggiornamento principale, ma il miglioramento su Terminal-Bench 2.1 (+19 punti) segnala il guadagno più significativo nella pratica per i flussi di lavoro agentici basati su terminale. Il cambio architetturale verso MoE significa anche che il costo di inferenza per token è diminuito anche mentre la capacità del modello è aumentata.
Posizione open-weight: licenza MIT e self-hosting
GLM-5.2 è rilasciato sotto licenza MIT senza restrizioni commerciali e senza esclusioni regionali — un contrasto deliberato con alcuni modelli di origine cinese che hanno incluso limitazioni geografiche nei loro termini di licenza. I pesi sono scaricabili pubblicamente a 1,51 TB. Per i fondamenti accademici della famiglia di modelli GLM, vedi il rapporto tecnico di GLM-4 su arXiv.
Il self-hosting del modello completo da 753 miliardi di parametri (1,51 TB) richiede un’infrastruttura GPU significativa — stimata in 8–16× schede di classe H100 per l’inferenza completa. Per i team che desiderano le garanzie dei pesi open senza hardware on-premises, esistono diverse opzioni gestite:
- OpenRouter — hosting di terze parti a ~$0,95/$3,00 input/output, contesto completo da 1M disponibile
- Cloudflare Workers AI — inferenza edge a bassa latenza, limite a 262K di contesto
- API gestita Z.ai — endpoint ufficiale con conformità SOC 2 e GDPR, tariffe $1,40/$4,40
- Hugging Face Inference API — varianti quantizzate per requisiti hardware ridotti
La conformità SOC 2 e GDPR si applica quando si utilizza il modello tramite l’API gestita di Z.ai. Le implementazioni self-hosted godono della stessa permissività dei pesi open, ma la responsabilità di conformità ricade sull’operatore.
FAQ
Che cos’è GLM-5.2?
GLM-5.2 è il modello linguistico open-weight di punta di Z.ai (già Zhipu AI), rilasciato nel giugno 2026 con 753 miliardi di parametri totali (40 miliardi attivi per token), una finestra di contesto da 1 milione di token e una licenza MIT. È ottimizzato per la programmazione, i flussi di lavoro agentici e i compiti di ragionamento a lungo orizzonte.
Come si confronta GLM-5.2 con GPT-5.5?
Su SWE-bench Pro, GLM-5.2 ottiene il 62.1% contro il 58.6% di GPT-5.5. Su FrontierSWE, GLM-5.2 raggiunge il 74.4% contro il 72.6% di GPT-5.5. Il prezzo dell’API è circa un sesto di quello di GPT-5.5, rendendo GLM-5.2 l’opzione più conveniente per i compiti di programmazione.
Qual è la finestra di contesto di GLM-5.2?
GLM-5.2 supporta una finestra di contesto da 1 milione di token, accessibile tramite l’ID modello glm-5.2[1m]. È 5 volte più grande del limite di ~200K di GLM-5.1. L’output massimo è di 131.072 token; con lo sforzo massimo, il modello può generare fino a 85K token di output per attività.
GLM-5.2 è open source?
GLM-5.2 è open-weight con licenza MIT: i pesi del modello sono scaricabili pubblicamente e liberamente utilizzabili a fini commerciali senza restrizioni regionali. Il codice di addestramento non è completamente aperto, ma i pesi sono disponibili su Hugging Face.
Quanto costa GLM-5.2?
Tramite API Z.ai: $1.40/1M token in input, $4.40/1M token in output, $0.26 per input in cache. Piani in abbonamento (GLM Coding Plan): Lite $18/mese, Pro $72/mese, Max $160/mese. I provider su OpenRouter offrono circa $0.95/$3.00 input/output.
Su quali benchmark si misura GLM-5.2?
SWE-bench Pro (62.1%), FrontierSWE (74.4%), Terminal-Bench 2.1 (81.0), matematica AIME 2026 (99.2%), Artificial Analysis Intelligence Index v4.1 (punteggio 51), Code Arena WebDev (2° posto) e rilevamento IDOR in ambito cybersecurity (F1 39%, superando Claude Code).
Posso eseguire GLM-5.2 in locale?
Sì — il modello completo (753 miliardi di parametri, 1.51 TB) richiede circa 8–16 GPU di classe H100. Una variante quantizzata è disponibile su Hugging Face (THUDM/GLM-Z1-9B-0414) per ambienti con risorse limitate. La licenza MIT consente il self-hosting e il fine-tuning senza restrizioni.
Come si usa GLM-5.2 con Claude Code?
Imposta ANTHROPIC_BASE_URL=https://api.z.ai/v1 e la tua chiave API Z.ai come ANTHROPIC_API_KEY. Passa –model glm-5.2 (o glm-5.2[1m] per il contesto da 1M) a Claude Code. Z.ai espone un endpoint compatibile con Anthropic, quindi non sono necessarie altre modifiche alla configurazione.