Chip AI Huawei Ascend: Specifiche, Modelli e Roadmap 2027 Spiegati
I principali laboratori AI della Cina addestrano sempre più modelli frontier sui processori Huawei Ascend — chip AI di produzione domestica che competono direttamente con le GPU per data center di NVIDIA. La piattaforma z ai e altri laboratori frontier eseguono ora l’intero stack di addestramento su hardware Ascend, a seguito delle restrizioni all’esportazione statunitensi che hanno bloccato l’accesso ai chip A100 e H100. Questa guida copre ogni generazione Ascend, dalla serie 910 alla prossima 970, i dati di performance reali e come l’Atlas SuperCluster sta ridisegnando l’infrastruttura AI globale.
La gamma Ascend va dal collaudato 910B alle generazioni pianificate 960 e 970, con prodotti di sistema come l’Atlas 950 SuperPoD che supera l’NVL144 di NVIDIA di 56,8 volte in scala e 15 volte in memoria totale.
Cosa Sono i Chip AI Huawei Ascend?
HiSilicon — il braccio interno di progettazione di semiconduttori di Huawei — sviluppa i processori Ascend per carichi di lavoro di addestramento AI su larga scala e di inferenza. I chip sono progettati per sostituire le GPU NVIDIA nei data center cinesi, una priorità urgente dopo che le restrizioni all’esportazione statunitensi hanno bloccato l’accesso all’hardware A100 e H100. La gamma Ascend di Huawei compete direttamente con il portafoglio data center di NVIDIA e consente all’industria AI cinese di operare indipendentemente dal calcolo controllato dagli Stati Uniti.
La serie Ascend non è nata come semplice reazione alle sanzioni. HiSilicon progettava acceleratori AI dal 2018 e l’Ascend 910 ha debuttato prima che entrassero in vigore i principali controlli all’esportazione. Ciò che è cambiato dopo il 2022 — e in particolare dopo il gennaio 2025 — è stata l’urgenza: ogni grande laboratorio AI cinese ha formalizzato una strategia Ascend-first e i volumi produttivi di Huawei sono cresciuti di conseguenza.
Progettazione e Finalità
I chip Ascend sono progettati specificamente per carichi di lavoro AI ad alta intensità di operazioni su matrici: addestramento di modelli linguistici di grandi dimensioni, generazione di immagini e inferenza su scala di data center. A differenza delle GPU di uso generale, l’architettura Ascend privilegia le operazioni su tensori e l’efficienza nel movimento dei dati. I chip si integrano con il framework MindSpore di Huawei e la linea di server Atlas, formando uno stack verticalmente integrato dal silicio al software — un parallelo deliberato con l’ecosistema CUDA/GPU di NVIDIA. Huawei gestisce il portale ufficiale per sviluppatori Ascend con documentazione completa su SDK e hardware.
L’ecosistema Ascend è composto da quattro livelli integrati:
- Silicio: chip Ascend progettati da HiSilicon, prodotti presso SMIC
- Memoria e interconnessione: HiZQ 2.0 HBM e UnifiedBus 2.0 / HiBL 1.0
- Server: unità rack Atlas 800T A2 e serie Atlas 900
- Software: framework MindSpore con livello di compatibilità CUDA tramite SIMT
Il Contesto Strategico
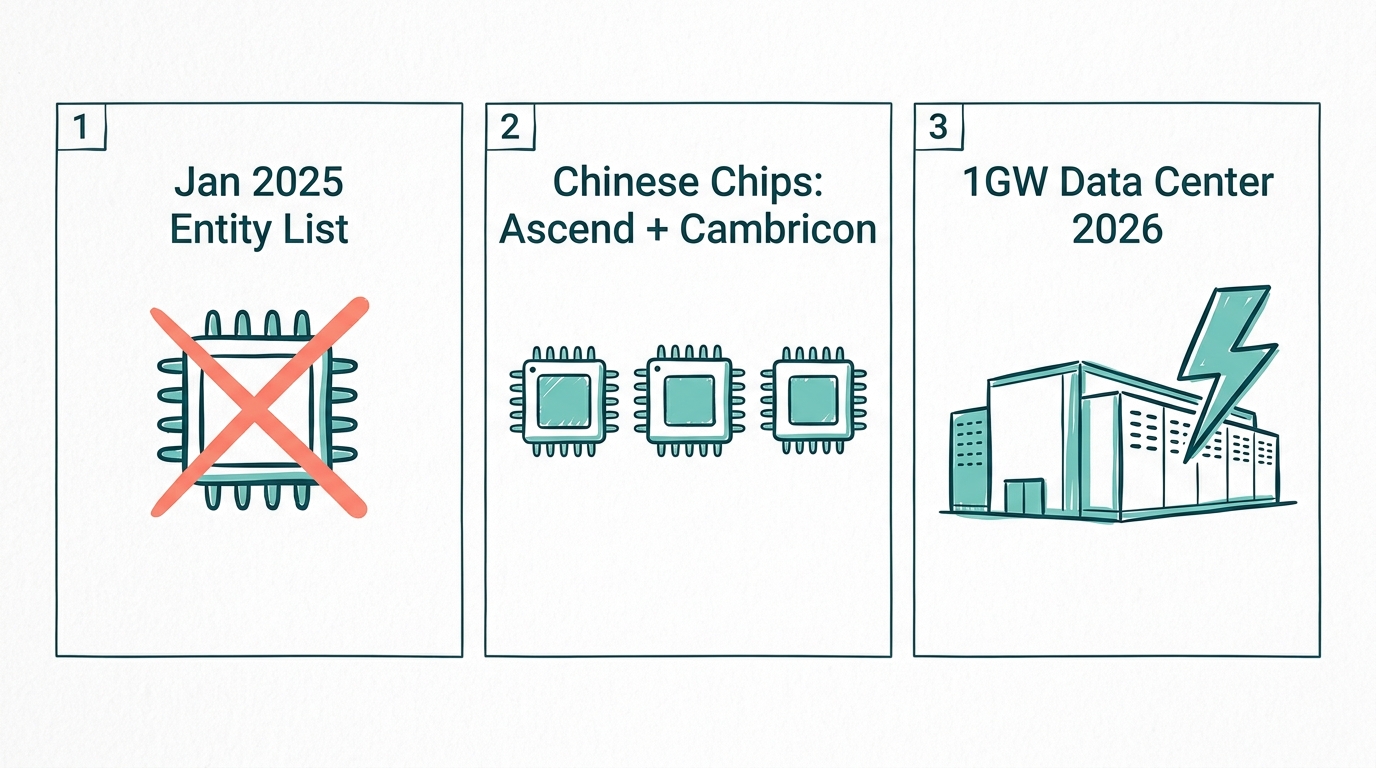
Dopo le aggiunte all’US Entity List del gennaio 2025, i laboratori AI cinesi — tra cui Zhipu AI, DeepSeek e Baidu — si sono rivolti ai chip Ascend come substrato computazionale principale. Huawei ha previsto ricavi da chip AI pari a 12 miliardi di dollari per il 2026, rispetto ai 7,5 miliardi del 2025, mentre la quota di mercato di NVIDIA in Cina si avvicinava a zero. La portata di questo cambiamento è senza precedenti nella storia dei semiconduttori: un’intera industria AI nazionale che passa a un unico fornitore domestico nell’arco di 18 mesi.
Generazioni di Chip Huawei Ascend: Gamma Completa dei Modelli
La famiglia di chip Ascend comprende tre generazioni in produzione e due generazioni in roadmap, ciascuna con obiettivi di performance e caratteristiche produttive distinte.
Serie Ascend 910 (Produzione Attuale)
L’Ascend 910B è il chip da lavoro di Huawei. GLM-5 — il modello frontier da 744 miliardi di parametri di Zhipu AI — è stato addestrato su un cluster di 100.000 chip Ascend 910B, che rimane il deployment Ascend su larga scala più documentato fino a oggi. L’Ascend 910c migliorato utilizza un nodo SMIC a 7nm con litografia DUV, offrendo 800 TFLOP/s a FP16 e 3,2 TB/s di larghezza di banda della memoria.
Il vincolo produttivo è significativo: i rendimenti DUV a 7nm si attestano intorno al 30%, il che significa che circa due terzi dei die prodotti vengono scartati. Nonostante ciò, Huawei ha spedito circa 600.000 unità Ascend 910C nel 2026, con la produzione totale di die Ascend su tutti i modelli prevista fino a 1,6 milioni per l’anno. Il volume compensa il rendimento.
Ascend 950 e 950PR (Flagship 2026)
L’Ascend 950 raggiunge 1 PFLOPS a FP8 e 2 PFLOPS a MXFP4 — segnando un salto generazionale rispetto alla serie 910. La variante 950PR va oltre: supera l’NVIDIA H20 di 2,87 volte nel throughput computazionale ed è l’unico chip AI cinese a supportare l’inferenza a precisione FP4 — una capacità riservata all’H100 NVL di NVIDIA e ai modelli successivi nel mercato globale.
L’Ascend 950DT raddoppia la densità di memoria a 144 GB di HiZQ 2.0 HBM — la memoria ad alta larghezza di banda proprietaria di Huawei — con 4 TB/s di larghezza di banda e 2 TB/s di interconnessione chip-to-chip tramite UnifiedBus 2.0. La variante DT è destinata alle sessioni di addestramento più grandi, dove la capacità di memoria è critica quanto il throughput computazionale.
Ascend 960 e 970 (Roadmap)
L’Ascend 960 è previsto per il Q4 2027, con l’obiettivo di circa il doppio della potenza di calcolo della generazione 950. Il 970 segue nel Q4 2028. Il presidente a rotazione di Huawei, Eric Xu, ha annunciato pubblicamente la roadmap triennale, segnalando una cadenza disciplinata verso il calcolo su scala ZFLOP — senza dipendere dalla litografia EUV di TSMC. L’Atlas 960 SuperCluster derivato dal chip 960 è previsto per erogare 2 ZFLOPS a FP8 e 4 ZFLOPS a FP4, collocandosi alla pari o in anticipo rispetto alla roadmap data center di prossima generazione di NVIDIA.
La tabella seguente riassume le specifiche delle generazioni Ascend:
| Chip | Nodo | Calcolo di Picco | Memoria | Caratteristica Principale |
|---|---|---|---|---|
| Ascend 910B | 7nm (SMIC DUV) | ~256 TFLOPS FP16 | 64 GB HBM2e | Collaudato su scala 100k chip |
| Ascend 910c | 7nm (SMIC DUV) | 800 TFLOPS FP16 | 96 GB HBM2e | 3,2 TB/s di larghezza di banda |
| Ascend 950 | Classe 6nm | 1.000 TFLOPS FP8 | 96 GB HBM | 2 PFLOPS MXFP4 |
| Ascend 950PR | Classe 6nm | ~1.560 TFLOPS | 96 GB HBM | Inferenza FP4, 2,87x H20 |
| Ascend 950DT | Classe 6nm | ~1.560 TFLOPS | 144 GB HiZQ 2.0 | 4 TB/s di larghezza di banda |
| Ascend 960 | Nodo avanzato | ~3.000 TFLOPS (stim.) | TBD | Q4 2027, 2x rispetto al 950 |
| Ascend 970 | Nodo avanzato | TBD | TBD | Q4 2028 |
Performance vs. NVIDIA: Dati di Benchmark
Benchmark a Livello di Chip
L’Ascend 950PR è il leader delle prestazioni nel mercato interno cinese dell’hardware AI. Offre un throughput computazionale pari a 2,87× quello dell’NVIDIA H20 — la GPU con le specifiche più elevate che la Cina può importare legalmente a partire dal 2025 nell’ambito degli attuali controlli all’esportazione. Il 950PR è anche l’unico processore AI cinese a supportare nativamente l’inferenza a precisione FP4.
Il confronto cambia quando si considera l’hardware NVIDIA senza restrizioni. L’H100 SXM5, disponibile a livello globale ma non in Cina, opera a circa 1.979 TFLOPS a FP8 — mantenendo un vantaggio sul 950PR a livello di chip. Tuttavia, i laboratori AI cinesi non competono con hardware senza restrizioni; competono con ciò che è effettivamente disponibile per loro.
| Chip | Calcolo di Picco | Precisione | vs. NVIDIA H20 |
|---|---|---|---|
| NVIDIA H20 | ~296 TFLOPS | FP8 | Riferimento |
| Ascend 910c | 800 TFLOPS | FP16 | ~1,35x (equivalente FP8) |
| Ascend 950 | 1.000 TFLOPS | FP8 | ~3,38x |
| Ascend 950PR | ~1.560 TFLOPS FP4 / 1.000 TFLOPS FP8 | FP4/FP8 | 2,87x (ufficiale) |
| NVIDIA H100 SXM5 | ~1.979 TFLOPS | FP8 | 6,69x (non disponibile in Cina) |
Precisione e Compatibilità Software
La serie Ascend 950 introduce HiBL 1.0, l’interconnessione a larghezza di banda elevata proprietaria di Huawei — un’alternativa funzionale a NVLink di NVIDIA per collegare più chip in un fabric computazionale coerente. HiBL 1.0 è essenziale per le sessioni di addestramento multi-chip in cui i colli di bottiglia nella larghezza di banda inter-chip possono annullare i guadagni di calcolo grezzo.
Per la portabilità del software, l’Ascend 950 introduce il supporto SIMT (Single Instruction Multiple Threads). SIMT consente ai carichi di lavoro scritti in CUDA di essere eseguiti su hardware Ascend con uno sforzo di porting ridotto — una significativa riduzione delle barriere per gli sviluppatori che migrano da NVIDIA. La piena compatibilità è ancora in evoluzione, ma il livello SIMT gestisce un sottoinsieme crescente di operatori comuni di deep learning utilizzati nell’addestramento e nell’inferenza di LLM.
Atlas SuperPoD e SuperCluster: Architettura a Livello di Sistema
Le specifiche dei singoli chip contano meno delle performance a livello di sistema nella scala dell’addestramento AI frontier. La linea di prodotti Atlas di Huawei assembla i chip Ascend in sistemi su scala rack e su scala cluster che competono direttamente con il DGX SuperPOD di NVIDIA.
Specifiche dell’Atlas 950 SuperPoD
L’Atlas 950 SuperPoD è il sistema AI su scala rack principale di Huawei. Ospita 8.192 chip Ascend 950 in 128 rack di calcolo più 32 rack di storage e rete, occupando circa 1.000 m² di spazio nel data center. In quella configurazione, eroga un calcolo AI aggregato che supera di gran lunga qualsiasi cosa NVIDIA spedisca attualmente come prodotto integrato.
Rispetto al sistema NVL144 di NVIDIA — la più grande unità NVIDIA integrata — l’Atlas 950 SuperPoD è 56,8 volte più grande in scala, offre 6,7 volte il calcolo aggregato e 15 volte la capacità di memoria totale a 1.152 TB. L’Atlas 960 SuperPoD scala ulteriormente, ospitando 15.488 chip in 176 rack di calcolo più 44 rack di supporto in circa 2.200 m².
La tabella seguente mette a confronto i due sistemi:
| Metrica | Atlas 950 SuperPoD | NVIDIA NVL144 | Rapporto |
|---|---|---|---|
| Numero di chip | 8.192 | 144 | 56,8x |
| Calcolo aggregato | ~9,6 EFLOPS FP8 | ~1,4 EFLOPS FP8 | 6,7x |
| Memoria totale | 1.152 TB | ~72 TB | 15x |
| Superficie | ~1.000 m² | ~50 m² | ~20x |
Atlas 950 SuperCluster
Collegando più SuperPoD si ottiene l’Atlas 950 SuperCluster: oltre 520.000 chip Ascend che erogano 524 EFLOPS di calcolo — 2,5 volte la scala del supercomputer Colossus di xAI, che ha brevemente detenuto il titolo di cluster di addestramento AI più grande del mondo. L’Atlas 950 SuperCluster opera anche a 1,3 volte l’efficienza energetica di Colossus su base per-EFLOP.
L’Atlas 960 SuperCluster, derivato dalla prossima generazione di chip 960, punta a una configurazione da un milione di chip che eroga 2 ZFLOPS a FP8 e 4 ZFLOPS a FP4 — cifre che rappresenterebbero un cambiamento qualitativo nella capacità di calcolo AI disponibile.
“La roadmap Ascend di Huawei dimostra che l’addestramento AI frontier su larga scala è realizzabile indipendentemente dalla tecnologia statunitense. La capacità di calcolo dell’Atlas 950 SuperCluster supera già quella dei principali cluster di addestramento AI statunitensi disponibili ai player commerciali.”Eric Xu, Presidente a Rotazione di Huawei, Annuncio della Roadmap Ascend
Produzione: SMIC, DUV e la Sfida del Rendimento
Come Huawei Produce Chip Senza TSMC
HiSilicon progetta i chip Ascend; SMIC (Semiconductor Manufacturing International Corporation) li produce utilizzando la litografia DUV (Deep Ultraviolet) di classe 7nm — il nodo più avanzato realizzabile senza le macchine EUV di ASML, il cui export verso la Cina è bloccato. L’EUV consente rendimenti superiori all’80% sui nodi più avanzati; il DUV a 7nm offre circa il 30%, il che significa che il 70% dei wafer prodotti genera die non funzionali.
Questo vincolo di rendimento rende ogni die Ascend funzionante più costoso dei chip comparabili prodotti da TSMC — ma Huawei affronta questo problema attraverso il volume e l’integrazione verticale. Controllando HiSilicon (progettazione), SMIC (produzione) e Atlas (integrazione di sistema), Huawei assorbe le perdite di rendimento lungo la supply chain senza dipendere da fornitori esterni soggetti a controlli all’esportazione.
Come un chip Huawei Ascend arriva a un data center:
- HiSilicon completa il design del chip e lo invia a SMIC per la produzione
- SMIC produce i wafer DUV a 7nm — con un rendimento di circa il 30% sui die funzionali
- I die funzionali vengono assemblati con HiZQ 2.0 HBM e l’interconnessione UnifiedBus 2.0
- I chip assemblati vengono testati e classificati per livello di performance
- I chip idonei vengono installati nei server Atlas 800T A2 o Atlas 900
- I server vengono montati in rack nelle configurazioni Atlas SuperPoD
- I SuperPoD si interconnettono tramite il fabric HiBL 1.0 nei deployment SuperCluster
UnifiedBus 2.0 e HiZQ 2.0
L’Ascend 950DT introduce la memoria ad alta larghezza di banda HiZQ 2.0 — l’alternativa HBM proprietaria di Huawei. La HBM standard di SK Hynix e Micron è soggetta a restrizioni all’esportazione statunitensi per gli acquirenti cinesi; HiZQ 2.0 è prodotta internamente, eliminando completamente quella dipendenza. UnifiedBus 2.0 fornisce l’interconnessione chip-to-chip ad alta velocità che lega i chip Ascend in un fabric coerente all’interno dei sistemi Atlas, con una larghezza di banda chip-to-chip di 2 TB/s sul 950DT.
La combinazione di HiZQ 2.0 e UnifiedBus 2.0 significa che la generazione Ascend 950 è, per la prima volta, un acceleratore AI interamente prodotto con componenti domestici, dal silicio alla memoria all’interconnessione — un traguardo che conta tanto strategicamente quanto tecnicamente.
Z.ai e i Modelli GLM su Ascend: Deployment nel Mondo Reale
L’Impegno di Zhipu AI verso l’Hardware Ascend
Zhipu AI — il team dietro Z.ai — ha costruito l’intero stack di addestramento e inferenza su Huawei Ascend dopo che le restrizioni all’esportazione statunitensi hanno reso l’hardware NVIDIA non disponibile. GLM-5, un modello frontier da 744 miliardi di parametri, è stato addestrato su un cluster di 100.000 chip Ascend 910B. Il successivo modello di generazione d’immagini GLM-Image è stato addestrato interamente su server Atlas 800T A2 attraverso il framework MindSpore di Huawei, ottenendo un punteggio CVTG-2K di 0,9116 — un risultato competitivo secondo gli standard internazionali per la qualità della generazione di immagini.
Il deployment di Zhipu AI è il caso più ampiamente documentato di addestramento su scala frontier su hardware Ascend e stabilisce un riferimento per ciò che il chipset può ottenere in produzione piuttosto che in benchmark controllati.
GLM-5 e AutoGLM: La Famiglia di Modelli Z.ai
La famiglia di modelli GLM-5 alimenta le capacità di ragionamento di Z.ai su scala produttiva, mentre AutoGLM gestisce compiti agentici e flussi di lavoro automatizzati — entrambi eseguono l’inferenza su cluster basati su Ascend. L’indipendenza della piattaforma Z.ai dall’hardware NVIDIA è ora una caratteristica strutturale della sua architettura, non un workaround temporaneo. Ciò significa che Z.ai può scalare la capacità computazionale acquistando chip Ascend sul mercato interno, senza esposizione al rischio di controlli all’esportazione.
MindSpore: Lo Stack Software Ascend
MindSpore è il framework AI open-source di Huawei, analogo a PyTorch o TensorFlow ma ottimizzato specificamente per l’hardware Ascend. Fornisce librerie di operatori, differenziazione automatica e primitive di addestramento distribuito che consentono ai ricercatori di scrivere codice per i chip Ascend senza ottimizzazione manuale a basso livello. Il framework gestisce la mappatura tra le operazioni standard di deep learning e il set di istruzioni nativo di Ascend. La documentazione completa di MindSpore è gestita da Huawei e copre l’integrazione della serie Ascend dalla 910 alla 950.
Huawei ha investito molto nei livelli di compatibilità CUDA all’interno di MindSpore e nel supporto SIMT sull’Ascend 950 per facilitare la migrazione dagli ecosistemi NVIDIA. Gli sviluppatori che portano codice di addestramento basato su PyTorch riferiscono che le architetture transformer comuni funzionano con relativamente poche modifiche — una scelta progettuale deliberata per ridurre i costi di transizione per i laboratori che in precedenza utilizzavano CUDA.
Le funzionalità principali di MindSpore rilevanti per i deployment Ascend includono:
- Fusione automatica degli operatori e ottimizzazione del layout della memoria per i core tensor di Ascend
- Addestramento distribuito su migliaia di chip Ascend con gradient checkpointing
- Livello di traduzione CUDA-to-Ascend tramite SIMT, che copre gli operatori transformer comuni
- Integrazione con i server Atlas 800T A2 per inferenza single-node e multi-node
- Model Zoo con modelli GLM, BERT e vision pre-addestrati adattati per Ascend
Restrizioni all’Esportazione USA e Indipendenza della Cina nel Settore dei Chip AI
Il Punto di Svolta di Gennaio 2025
L’aggiornamento dei controlli all’esportazione del Dipartimento del Commercio statunitense del gennaio 2025 ha bloccato virtualmente tutti i chip AI ad alte prestazioni — incluso l’NVIDIA H20 — dalla vendita a entità cinesi. Questo ha esteso i controlli precedenti che avevano già limitato le esportazioni di A100 e H100. Il risultato è stato un distacco quasi completo dei laboratori AI cinesi dalla fornitura globale di hardware AI di classe frontier.
La risposta di Huawei è stata rapida: la roadmap Ascend è stata accelerata, i volumi produttivi si sono espansi e i laboratori AI cinesi hanno formalizzato le loro strategie Ascend-first. Entro la metà del 2026, la quota di NVIDIA nel mercato cinese dei chip AI per data center aveva effettivamente raggiunto lo zero. I controlli all’esportazione destinati a rallentare le capacità AI della Cina sembrano invece aver accelerato lo sviluppo di un ecosistema hardware AI domestico indipendente.
Ricavi e Posizione di Mercato
Huawei ha registrato circa 7,5 miliardi di dollari di ricavi da chip AI nel 2025. L’azienda ha previsto 12 miliardi di dollari per il 2026, rendendo Huawei il fornitore dominante di calcolo AI per data center in Cina con un margine sostanziale. Cambricon e Moore Threads svolgono ruoli secondari nell’ecosistema hardware AI domestico — in particolare per l’inferenza e il deployment edge — ma i chip Ascend dominano i carichi di lavoro di addestramento frontier dove contano di più le performance per watt e la larghezza di banda dell’interconnessione.
La seguente traiettoria dei ricavi riflette la rapidità con cui il mercato si è spostato:
- 2023: Huawei inizia a spedire Ascend 910B su larga scala agli hyperscaler cinesi
- 2024: Gli ordini Ascend aumentano vertiginosamente con la revoca delle licenze di esportazione dell’NVIDIA H800; ricavi di circa 4 miliardi di dollari
- 2025: Divieto H20 confermato; i ricavi da chip AI di Huawei raggiungono 7,5 miliardi di dollari
- 2026 (previsto): 12 miliardi di dollari, trainati dal ramp-up produttivo dell’Ascend 950
Implicazioni per l’AI Globale
L’ecosistema Ascend dimostra che l’addestramento AI frontier su larga scala è realizzabile senza la tecnologia EUV di TSMC o le GPU NVIDIA. Con gli Atlas 950 SuperCluster che già superano il Colossus di xAI in scala grezza, e i cluster Atlas 960 che puntano al calcolo su scala ZFLOP, la traiettoria dell’infrastruttura AI cinese non dipende più dalla tecnologia controllata dagli Stati Uniti. La ricerca tecnica ChatGLM pubblicata tramite il rapporto tecnico ChatGLM documenta come Zhipu AI ha adattato le metodologie di addestramento per l’architettura Ascend, fornendo un riferimento pubblico per le adattazioni software richieste su larga scala.
L’implicazione per l’industria AI globale è significativa: l’assunzione che l’AI frontier richieda hardware NVIDIA e produzione TSMC non è più valida. Esistono ora due ecosistemi di calcolo AI paralleli, con Ascend e NVIDIA che si sviluppano in gran parte indipendentemente l’uno dall’altro.
FAQ
Cos’è il chip Huawei Ascend?
Huawei Ascend è una famiglia di chip acceleratori per l’intelligenza artificiale progettati da HiSilicon (la divisione semiconduttori di Huawei) per il training e l’inferenza di modelli di machine learning su larga scala. La gamma spazia dalla serie Ascend 910 (attualmente in produzione) fino alle prossime generazioni 960 e 970, prodotte da SMIC in Cina senza dipendere da hardware soggetto a controllo statunitense né dalla tecnologia EUV di TSMC.
Come si confronta Huawei Ascend con Nvidia?
L’Ascend 950PR offre una potenza di calcolo 2,87 volte superiore a quella della NVIDIA H20 — la migliore GPU legalmente disponibile in Cina nel 2025. A livello di sistema, l’Atlas 950 SuperPoD garantisce una scala 56,8 volte maggiore, una potenza di calcolo aggregata 6,7 volte superiore e una memoria 15 volte più ampia rispetto al sistema NVIDIA NVL144. A livello di singolo chip, Ascend rimane ancora indietro rispetto alle H100/H200 di NVIDIA disponibili senza restrizioni nel resto del mondo, ma il divario si riduce a ogni nuova generazione.
Qual è il chip Huawei Ascend più recente?
A partire dal 2026, l’Ascend 950PR è il chip Ascend più performante in produzione: raggiunge circa 1.560 TFLOPS e supporta l’inferenza FP4, risultando l’unico chip AI cinese a farlo. L’Ascend 960 è previsto per il quarto trimestre del 2027, con una potenza di calcolo circa doppia rispetto alla serie 950.
Huawei Ascend è disponibile al di fuori della Cina?
I chip Huawei Ascend vengono distribuiti principalmente nel mercato interno cinese e tramite le partnership cloud internazionali di Huawei. L’esportazione diretta è limitata sia dai controlli all’esportazione statunitensi sia dalle preoccupazioni del governo cinese riguardo alla fuoriuscita di hardware strategico dal paese. L’accesso internazionale avviene principalmente attraverso i servizi di Huawei Cloud.
Quali modelli di intelligenza artificiale vengono addestrati su Huawei Ascend?
Tra i principali modelli di IA addestrati su Ascend figurano GLM-5 (744 miliardi di parametri, addestrato da Zhipu AI su 100.000 chip Ascend 910B), GLM-Image (il modello visivo di Zhipu AI, addestrato su server Atlas 800T A2) e diverse varianti dei modelli DeepSeek. Il deployment di Zhipu AI rappresenta la sessione di addestramento su Ascend a scala frontier più ampiamente documentata.
Cos’è MindSpore?
MindSpore è il framework open source di deep learning sviluppato da Huawei, ottimizzato per i processori AI Ascend. Rappresenta l’equivalente di PyTorch e TensorFlow per l’ecosistema Ascend, offrendo differenziazione automatica, addestramento distribuito, librerie di operatori e livelli di compatibilità con CUDA per semplificare la migrazione dai flussi di lavoro NVIDIA.
Huawei Ascend può eseguire carichi di lavoro CUDA?
La generazione Ascend 950 introduce il supporto SIMT (Single Instruction Multiple Threads), che consente al codice scritto per CUDA di essere eseguito su hardware Ascend con uno sforzo di porting ridotto. La piena compatibilità con CUDA è ancora in fase di sviluppo, ma il livello SIMT gestisce già un sottoinsieme crescente di operatori comuni nel deep learning, rendendo Ascend una piattaforma sempre più praticabile per gli sviluppatori che migrano dagli ambienti NVIDIA.